成功学案例、五星好评、安全返航的战机——
它们有一个共同点:失败的那部分,常常不在画面里。
我们天生相信看得见、数得清的东西。但统计里有个陷阱:样本往往只来自「还活着、还在场、还愿意说话」的那一群人——沉默的多数或少数,恰恰可能改写结论。
只分析「幸存下来」的样本,忽略了已消失的那部分——结论被幸存者带偏。
媒体、平台、演讲者只展示「好看的故事」,失败案例被折叠或遗忘。
没有记录、没有发声、没有返回的数据——像沉在水下的冰山。
你分析的不是「全部事实」,而是能进入你视野的那一块。防坑的第一步:问一句——「我没看到什么?」
这是统计学里最经典的直觉题之一。二战时,盟军统计返航战机上的弹孔分布,发现机身、机翼弹孔密密麻麻,驾驶舱和引擎相对很少。
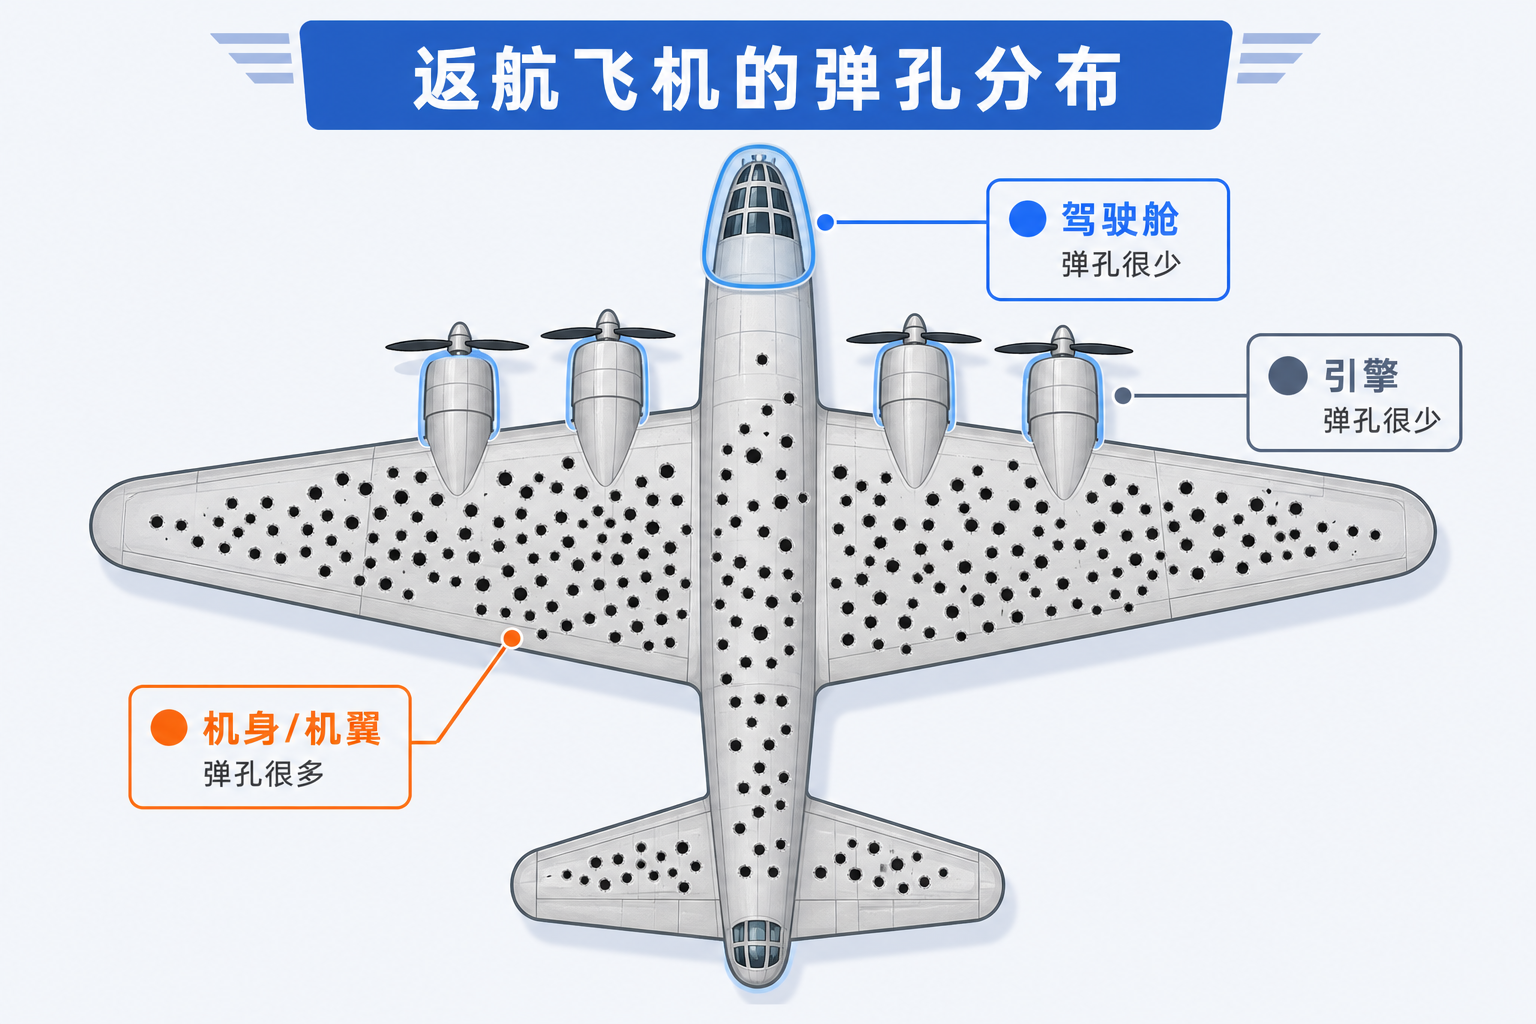
弹孔多的地方说明「经常被打中」——那就给机身和机翼加钢板,对吧?
返航样本里弹孔稀疏的区域,才是致命弱点——应优先加固引擎、驾驶舱等「少洞但致命」的位置。机身虽洞多,但飞机仍能返航,说明这些部位更扛打。
老建筑「百毒不侵」——可能是质量差的那批早就塌了;创业成功者分享经验——失败的那 90% 很少上台演讲。样本 = 幸存者,不等于全体。
即使没有人故意造假,报道机制也会筛掉大量「不好看」的信息——这叫选择性报道(或发表偏倚的一种表现)。
「某方法三天见效」上了头条;试了无效、甚至受伤的人,通常不会成为新闻。App 商店默认展示「最新好评」,差评沉底——你刷到的五星,不代表全体用户。
传记、访谈、商学院案例:主角几乎都是赢家。输家的路径、中途退出的原因、运气成分——很少被系统记录。你读到的是经过筛选的励志样本,不是成功概率的客观估计。
「显著」的实验更容易被发表;重复失败的结果难登期刊——这叫发表偏倚。大众读到的「科学结论」,有时也是被发表筛选过的子集。(进阶话题,这里只建立直觉。)
「沉默的数据」泛指本应纳入分析、却因各种原因缺失的记录:坠毁的战机、删帖的用户、退出调查的人、不愿透露收入的家庭……
返航战机、
五星评论、
还在职的员工
未返航的、
一星差评、
已离职的人
往往和结果本身有关:最不满意的人更可能卸载 App;伤势最重的人无法填写问卷;破产的公司不会出现在「百年企业」名单里。这种「非随机缺失」会系统性地扭曲判断。
不需要成为统计学家,遇到数字、案例、排行榜时,用下面几个问题快速自检:
你可以试试:先做一次弹孔加固选择题,再翻牌看看「没回来的飞机」;然后切换好评筛选,对比「全部评价」和「只看五星」差多远。
下图是成功返航的轰炸机统计。你会优先加固哪里?
返航样本示意图 · 对照选项作答
选一项,看看直觉会把加固板加在哪里——然后翻牌揭晓「没回来的飞机」。
那些没有返航的轰炸机,弹孔分布怎样?
点一下揭晓 →未返航飞机往往在驾驶舱和引擎中弹——致命一击,无法统计。返航样本里这些部位「洞少」,不是因为打不中,而是因为打中的没活着回来。
瓦尔德建议加固哪里?
点一下揭晓 →优先加固驾驶舱与引擎——返航样本中弹孔稀疏的致命区。机身虽洞多,但飞机仍能返航,说明这些命中「相对可承受」。
同一批 20 条真实评价(含 1–5 星)。切换视图,看「选择性展示」如何改变印象。
全部评价下,平均约 3.6 星——产品「还行但有槽点」。只看 5 星时,印象会完全不同。