我们面对的可能是一个极其困难的问题,解决它所需的时间未知,而整个人类的未来,很可能系于此。 —— Nick Bostrom
欢迎来到「等等,这怎么可能是我正在读的东西?我不明白为什么大家不在谈论这个」系列的第二部分。
上篇开头还算温和:我们讨论了狭义人工智能(ANI),以及它如何已经遍布当今世界;又分析了从 ANI 到通用人工智能(AGI)为何如此艰难,以及技术指数级进步为何暗示 AGI 可能比想象中更近。上篇结尾,我向你抛出了一个事实:一旦我们的机器达到人类水平智能,它们可能会立刻做这件事——
这让我们坐在屏幕前,面对「可能在我们有生之年到来的超级智能(ASI)」这一激烈概念,努力搞清楚我们该带着什么情绪去想它。
在深入之前,先提醒一下:一台机器成为「超级智能」意味着什么。
一个关键区分是速度型超级智能与质量型超级智能。很多人一想到超级聪明的计算机,首先想象的是:它和人类一样聪明,但思考速度快得多——比如一台像人一样思考、却快一百万倍的机器,能在五分钟内完成人类十年才能想明白的事。这听起来很惊人,ASI 确实会比任何人类快得多——但真正的分水岭是智力质量上的优势,那是完全不同的东西。
让人类比黑猩猩在智力上强那么多的,并不是思考速度的差异——而是人脑拥有一系列复杂的认知模块,能支撑复杂语言表述、长期规划、抽象推理,而黑猩猩的大脑没有。就算把黑猩猩的大脑加速几千倍,给它十年时间,它也搞不定如何用一套定制工具组装一个复杂模型——而人类几小时就能搞定。存在整片人类认知能力的世界,黑猩猩永远进不去,不管它花多少时间尝试。
但问题不只是黑猩猩做不到我们做的事——而是它的大脑无法理解那些世界甚至存在。黑猩猩可以熟稔「人类是什么」「摩天大楼是什么」,但它永远无法理解摩天大楼是人类建造的。在它的世界里,任何那么巨大的东西都是自然的一部分,句号——不仅它自己造不出摩天大楼,它甚至无法意识到「有人能造摩天大楼」。这就是智力质量上一点点差距的结果。
而在我们今天讨论的智力范围里——甚至在生物界的较小范围内——黑猩猩到人类的智力质量差距,其实小得可怜。Tim Urban 曾用一段楼梯来描绘生物认知能力的范围:
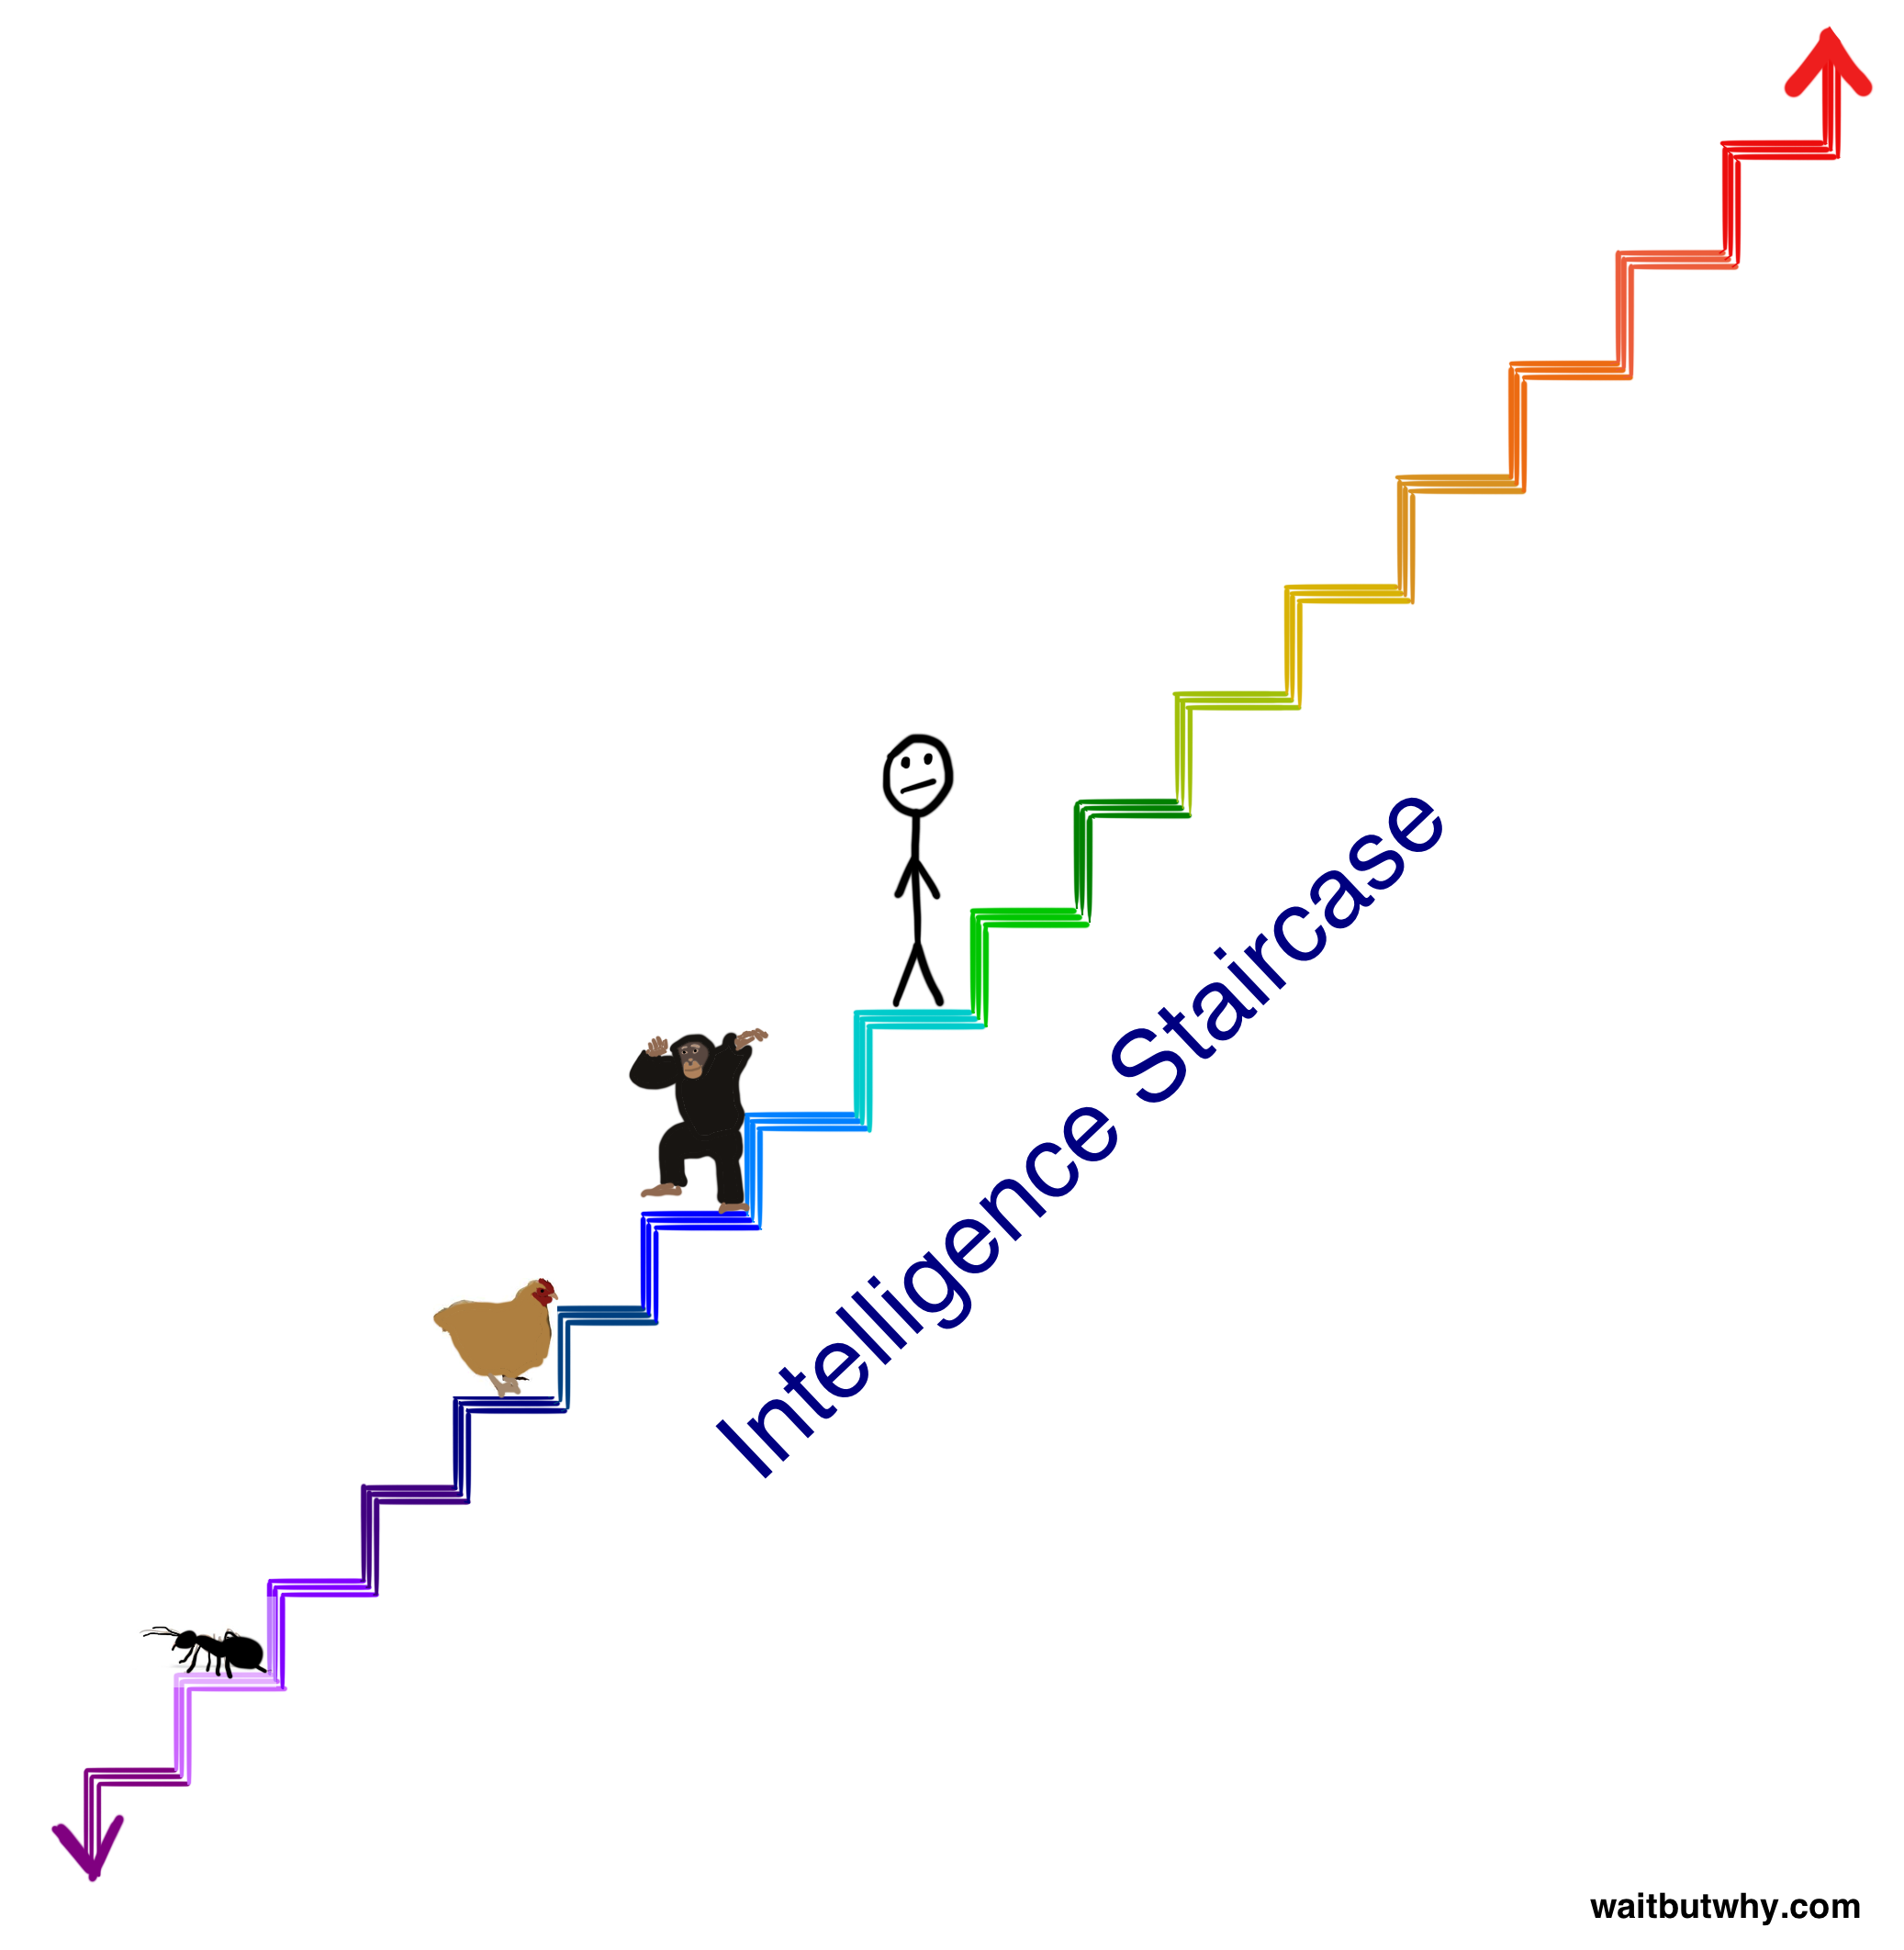
要体会一台超级智能机器有多大回事,想象一台站在人类上方两级、深绿色台阶上的机器。它只是「略微」超级智能,但相对我们的认知提升,就像刚才描述的黑猩猩/人类差距一样巨大。就像黑猩猩永远无法理解摩天大楼能被建造,我们也永远无法理解——哪怕机器试图解释——深绿色台阶上的机器能做什么,更不用说自己去做。而那还只是比我们高两级。站在楼梯倒数第二级上的机器,对我们而言,就像我们对蚂蚁——它可能花几年试图教给我们它所知道的最简单一丝一毫,努力也是徒劳的。
但我们今天讨论的超级智能,远远超出这段楼梯上的任何东西。在智能爆炸中——机器越聪明,就越快提升自身智能,直到开始向上飞奔——一台机器可能花几年从黑猩猩台阶升到上面一级,但一旦到了人类上方两级的深绿色台阶,也许只需几小时就能再跳一级;等它比我们高十级时,可能每一秒都在四步四步地往上跳。这就是为什么我们必须意识到:很可能在「第一台机器达到人类水平 AGI」这条大新闻出现之后极短时间内,我们就要面对与某个在这段楼梯上(或者也许比它高一百万倍)的东西共存于地球的现实:
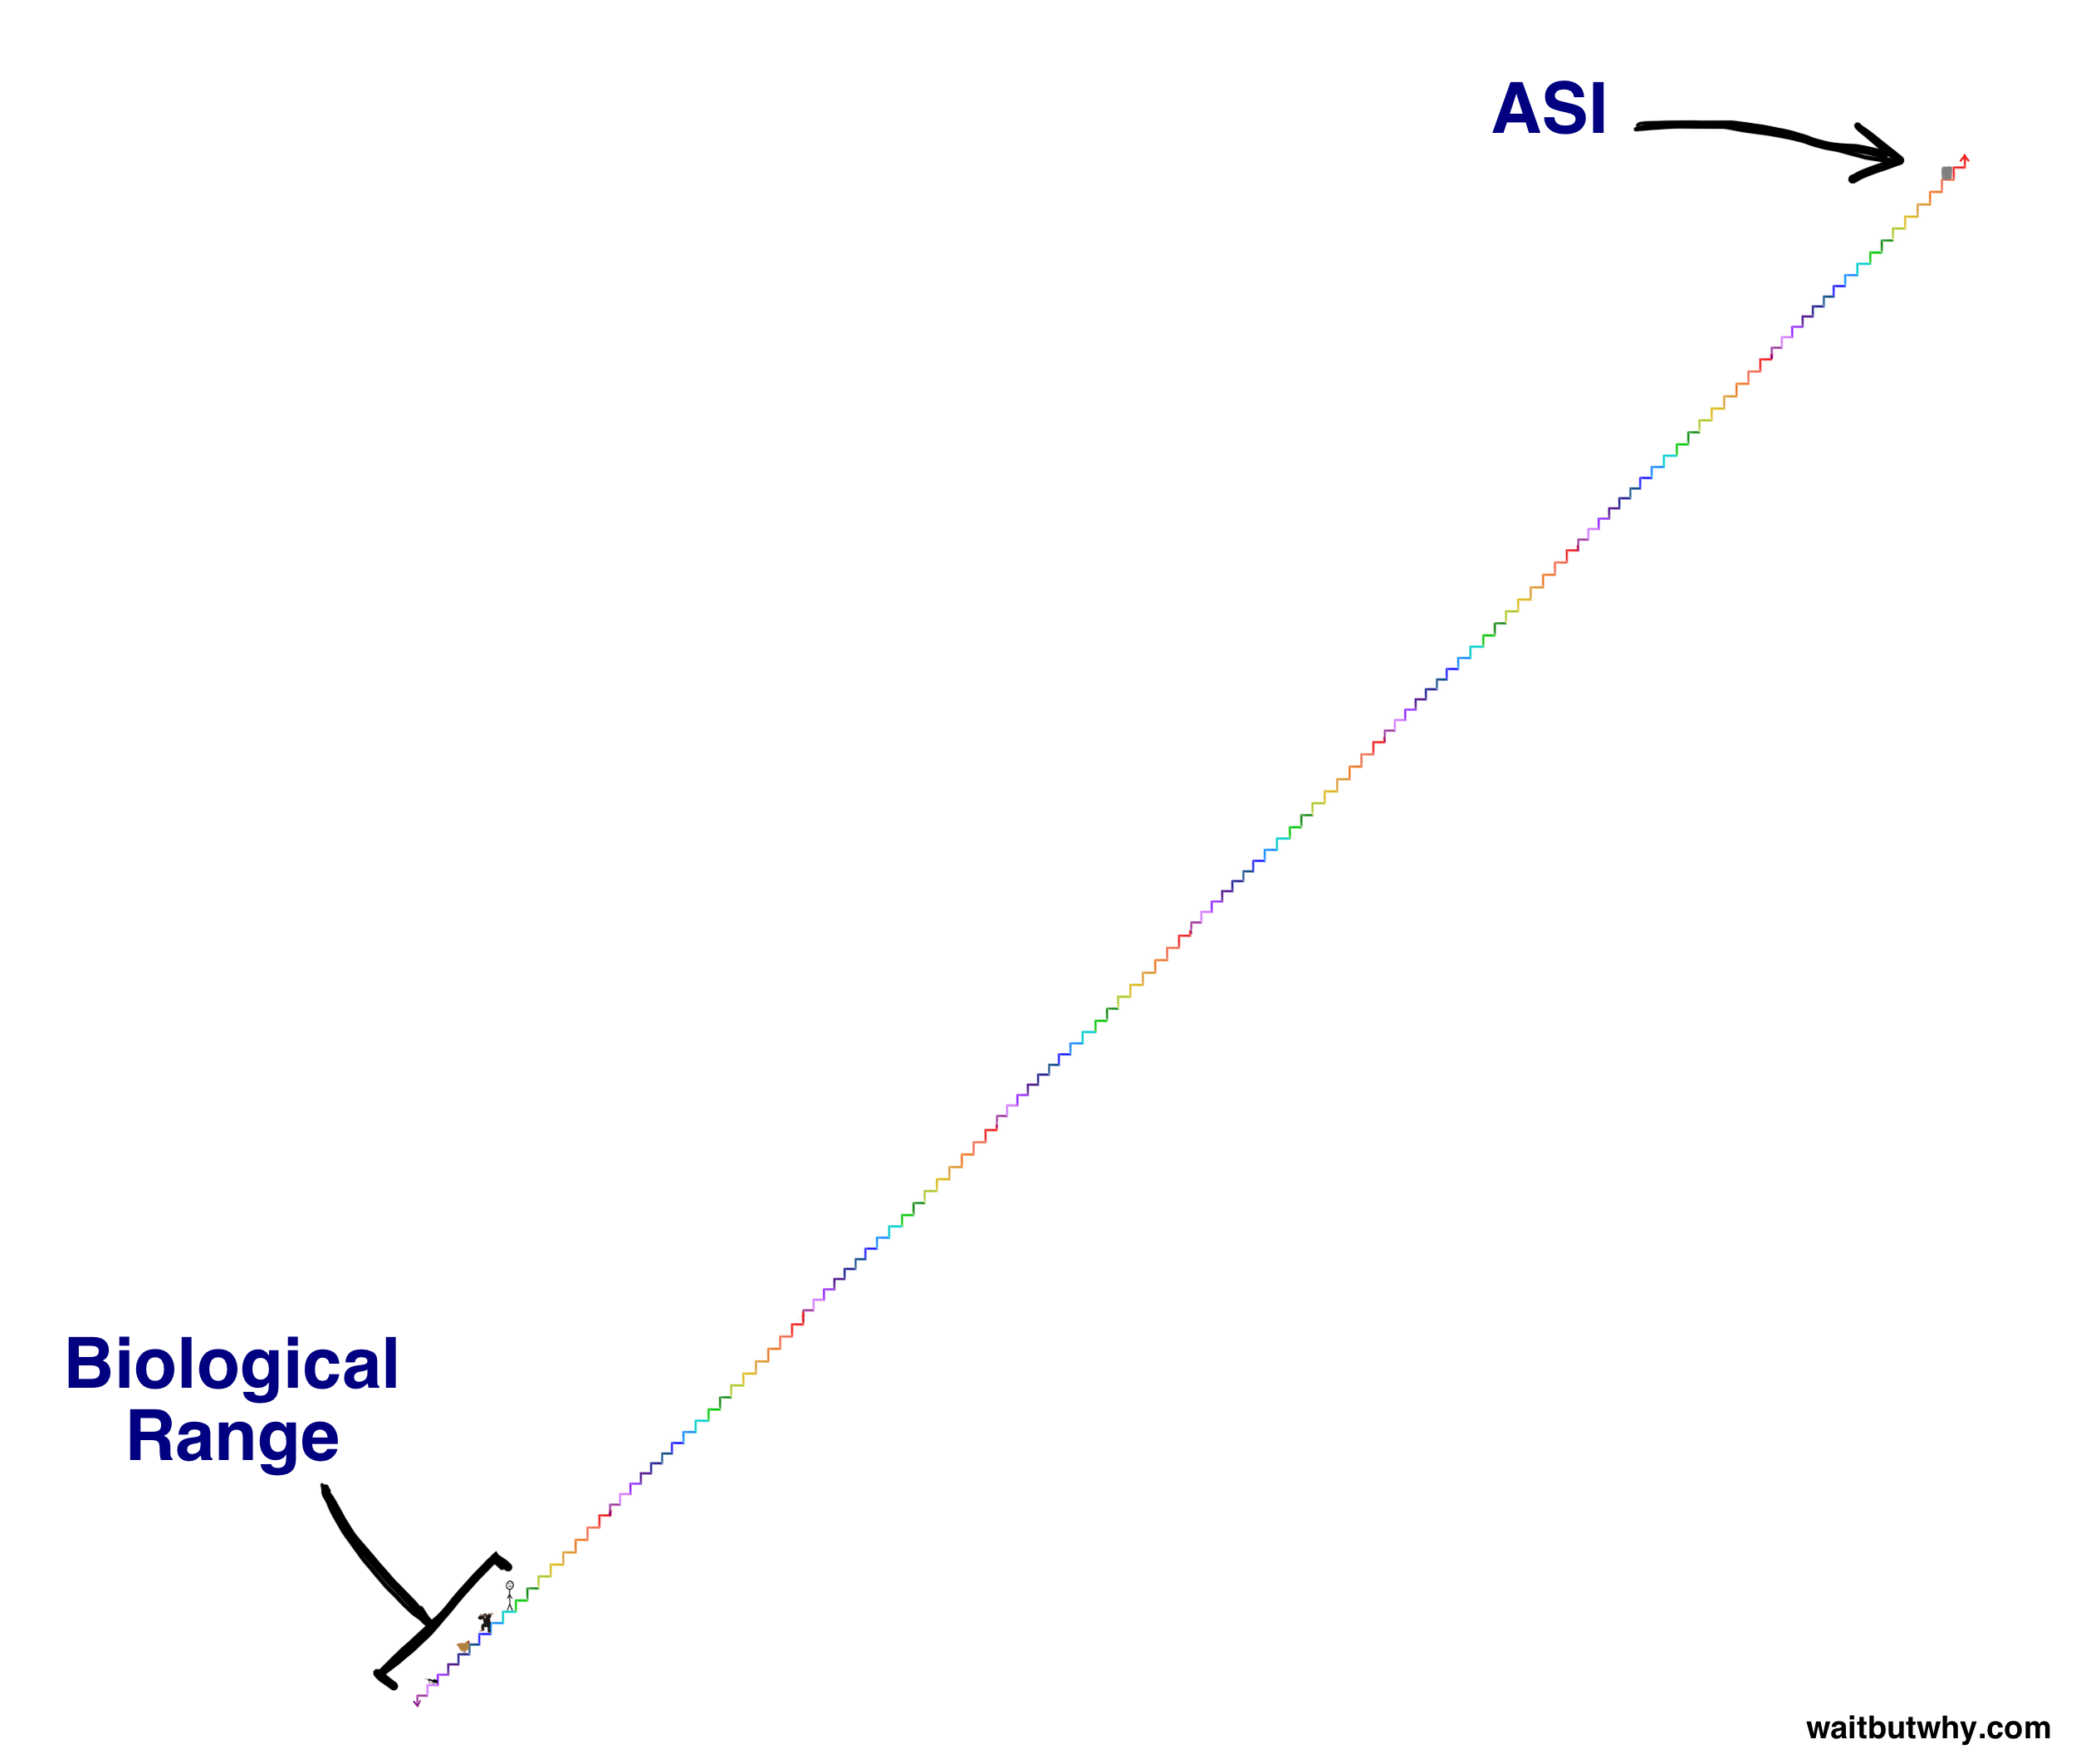
既然我们刚刚确立:试图理解只比我们高两级的机器的力量是徒劳之举,那就非常具体地声明一次:没有任何办法知道 ASI 会做什么,或对我们有什么后果。任何假装不然的人,都不理解超级智能意味着什么。
进化在数万年里缓慢、渐进地推进生物大脑;从这个意义上说,如果人类「生出」一台 ASI 机器,我们就是在剧烈地踏进进化。或者,也许这就是进化的一部分——也许进化的运作方式是:智能一点点爬升,直到达到能创造机器超级智能的水平,而那个水平就像一条绊线(tripwire),触发一场改写常规规则、决定所有生命新未来的全球分岔:
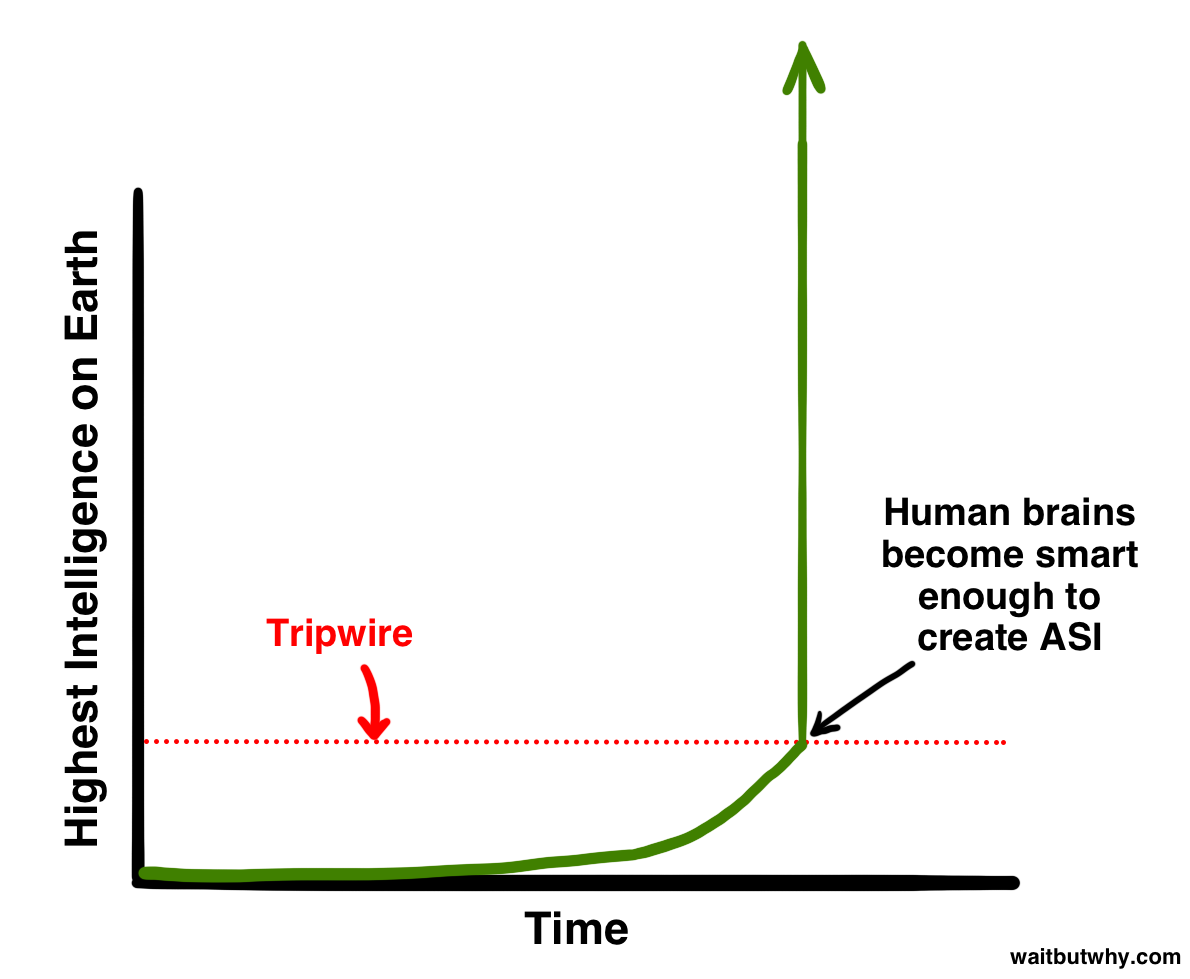
出于后文会讨论的原因,科学界很大一部分人相信:问题不是会不会碰到绊线,而是什么时候。有点疯狂的信息。
那我们处于什么境地?
世上没有人——当然也包括我——能告诉你碰到绊线时会发生什么。但牛津哲学家、AI 思想领袖 Nick Bostrom 认为,我们可以把所有可能结果归为两大类。
首先,看历史,生命是这样运作的:物种出现,存在一段时间,然后不可避免地,它们从存在的平衡木上跌落,惨遭灭绝——
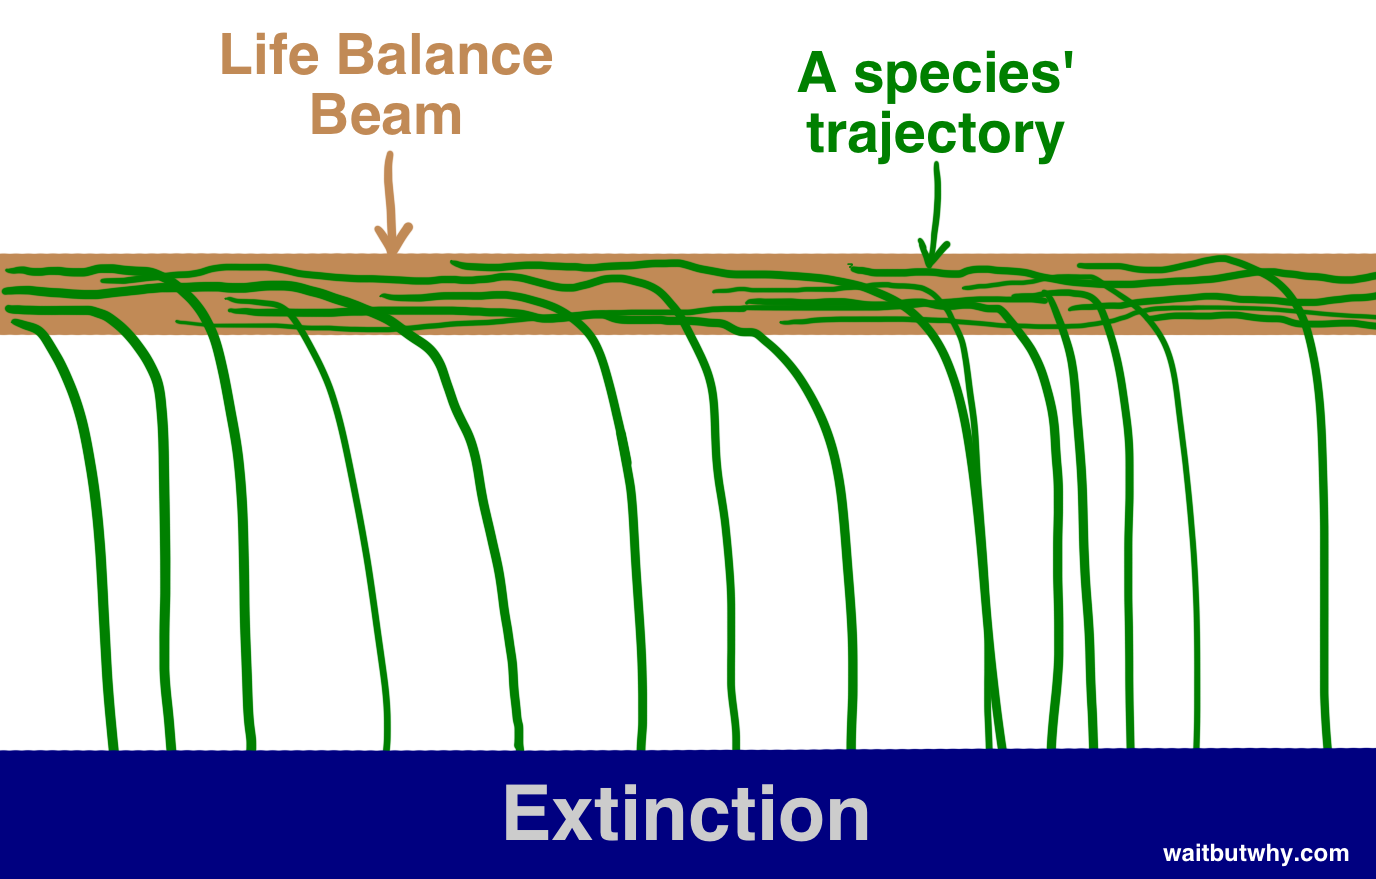
到目前为止,99.9% 的物种已从平衡木跌落。似乎很清楚:如果一个物种一直在平衡木上摇摇晃晃地前行,迟早会有别的物种、一阵自然之风,或一颗突然撞动平衡木的小行星把它撞下去。Bostrom 把灭绝称为一种吸引态(attractor state)——所有物种都摇晃欲靠地要掉进去、且从未有物种从中返回的地方。
我接触的大多数科学家都承认 ASI 有能力把人类送进灭绝;但也有许多人相信,若被善加利用,ASI 的能力可以把个体人类乃至整个物种带向第二个吸引态——物种永生(species immortality)。Bostrom 认为物种永生与物种灭绝一样是吸引态——也就是说,若我们设法到达那里,我们将永远不受灭绝之扰——我们征服了死亡,征服了偶然。所以尽管所有物种迄今都跌落在灭绝一侧,Bostrom 相信平衡木有两侧,只是地球上还没有任何东西足够聪明,能想出如何跌落到另一侧。
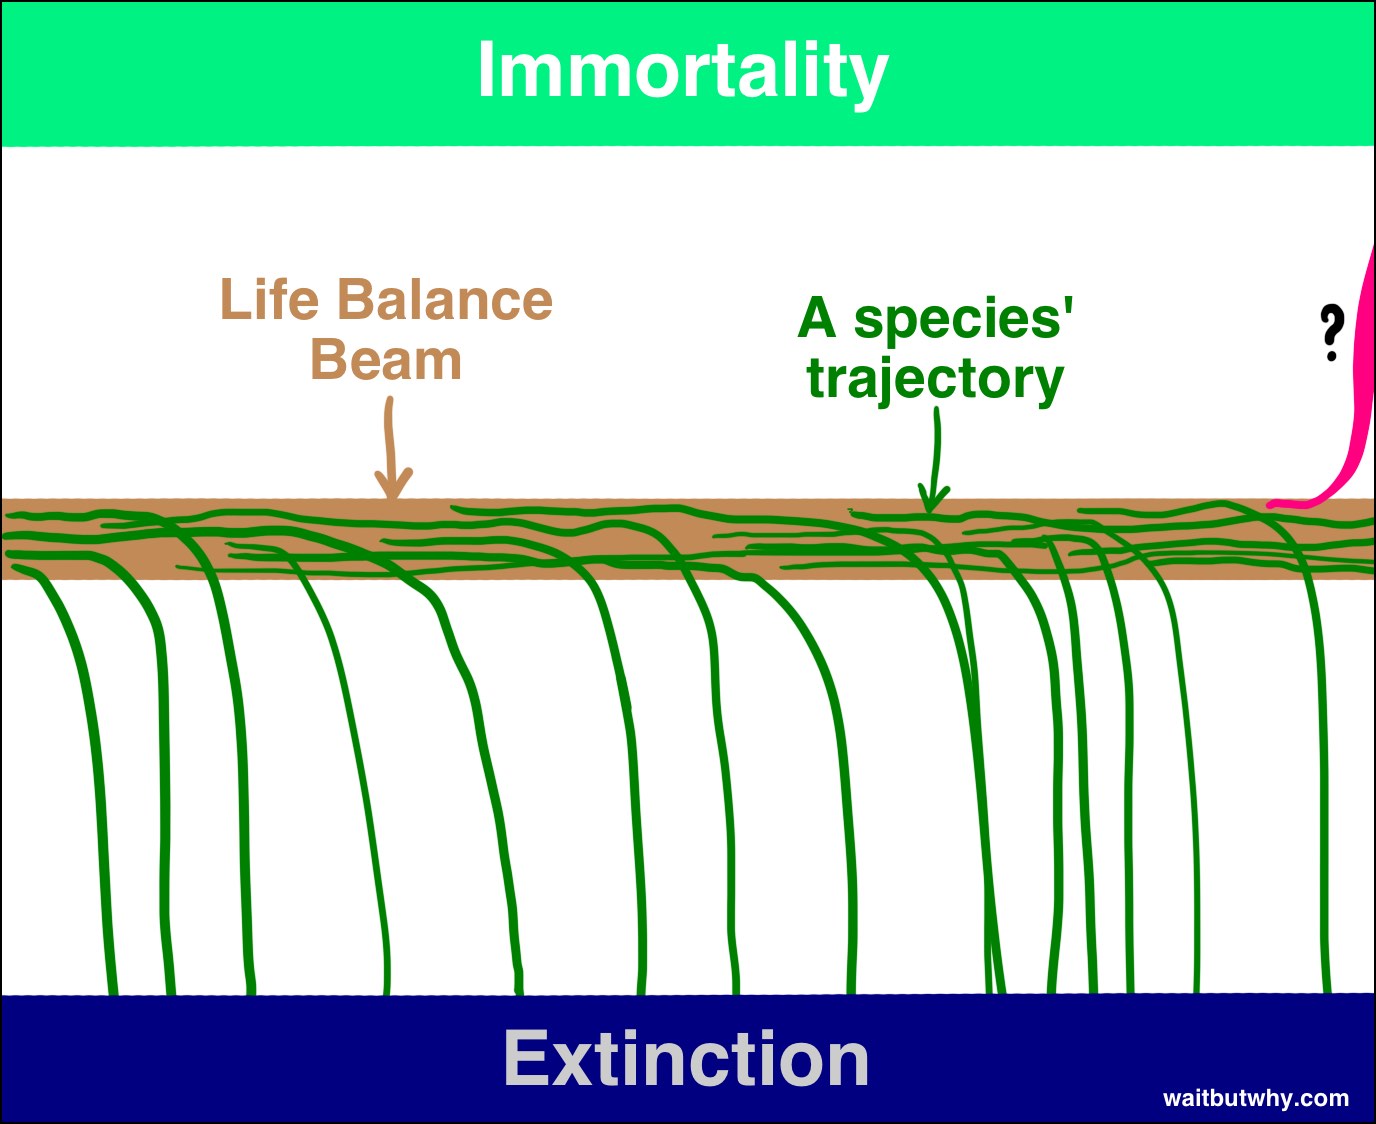
如果 Bostrom 和其他人是对的——从我读的一切来看,他们很可能是——我们有两个相当令人震惊的事实要消化:
- ASI 的到来,将第一次打开一个物种落在平衡木永生侧的可能性。
- ASI 的到来,将造成难以想象的剧烈冲击,很可能把人类这个物种从平衡木上撞下去——方向不定。
很可能当进化碰到绊线时,它会永久结束人类与平衡木的关系,创造一个有或无人类皆可的新世界。
似乎唯一值得每个人现在问的问题是:
我们什么时候会碰到绊线?届时会落在平衡木的哪一侧?
世上没有人知道这两个问题的答案,但许多最聪明的人为此投入了数十年思考。本文余下部分将探索他们得出的结论。
我们什么时候会碰到绊线?
也就是说:第一台机器达到超级智能还要多久?
毫不意外,意见分歧极大,这是科学家与思想家之间激烈辩论的话题。许多人——如 Vernor Vinge 教授、Ben Goertzel 科学家、Sun Microsystems 联合创始人 Bill Joy,或最著名的发明家与未来学家 Ray Kurzweil——同意机器学习专家 Jeremy Howard 在 TED 演讲中展示的这张图的判断:
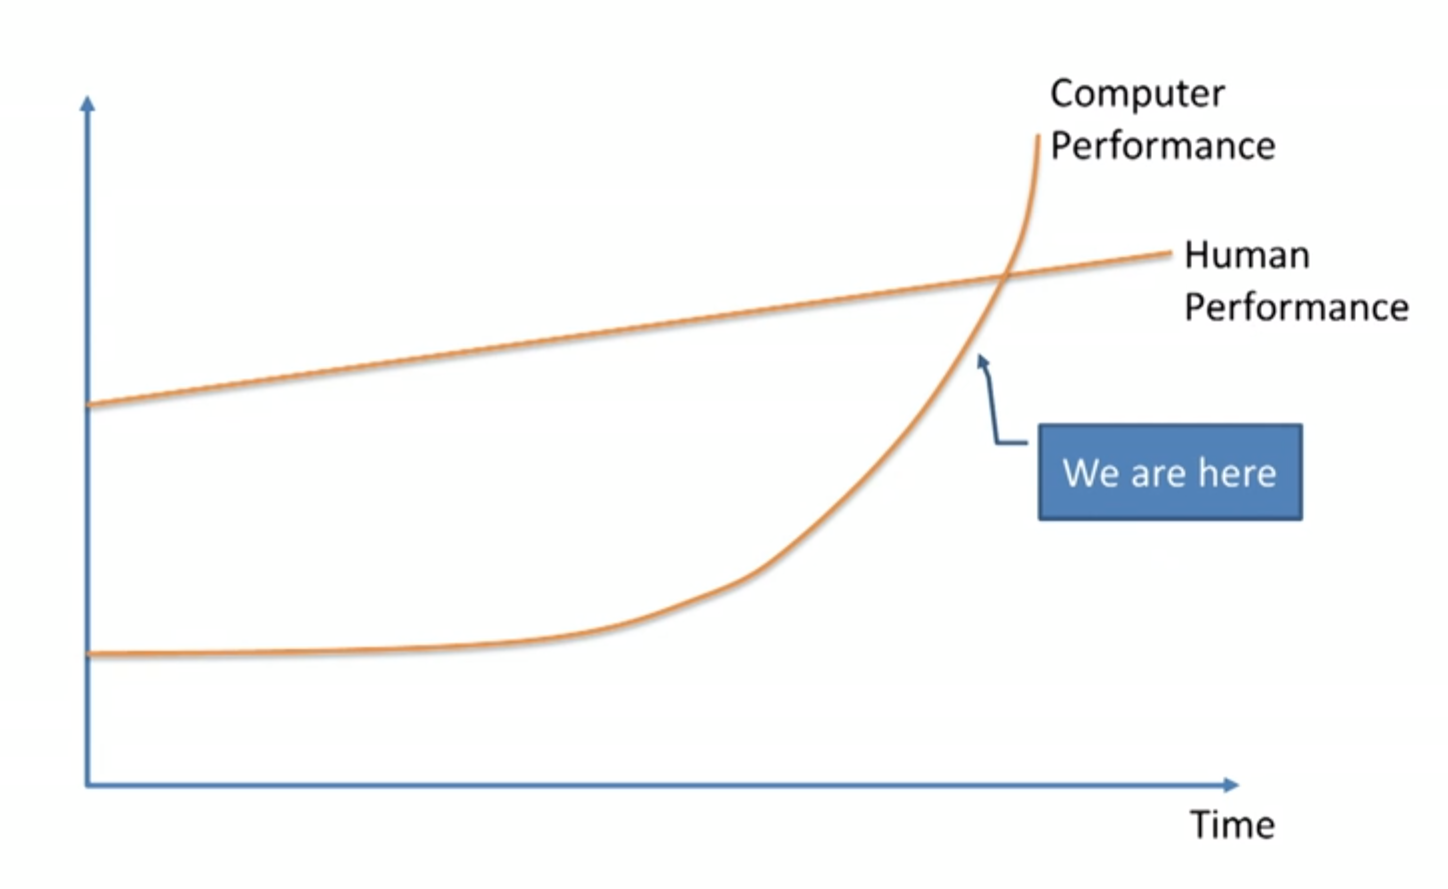
这些人相信事情很快会发生——指数增长正在起作用,机器学习现在只是缓慢向我们靠近,却会在未来几十年内一掠而过、把我们甩在身后。
另一些人——如 Microsoft 联合创始人 Paul Allen、研究心理学家 Gary Marcus、NYU 计算机科学家 Ernest Davis、科技企业家 Mitch Kapor——认为 Kurzweil 一派严重低估了挑战的难度,我们其实并没有那么接近绊线。
Kurzweil 阵营会反驳:真正被低估的是对指数增长的轻视;他们会把怀疑者比作 1985 年看着互联网缓慢生长的幼苗、争论它近期不可能产生重大影响的人。
怀疑者可能回辩:智能方面每进一步所需进步也呈指数级地更难,会抵消技术进步的典型指数特性。如此往复。
第三阵营,包括 Nick Bostrom,认为两组都没有理由对时间线感到确定;既承认 A)这完全可能在不远的未来发生,也承认 B)没有保证——也可能需要更久。
还有哲学家 Hubert Dreyfus 等人,认为这三组都天真——更可能 ASI 实际上永远不会被实现。
把这些意见放在一起,你会得到什么?
专家调查
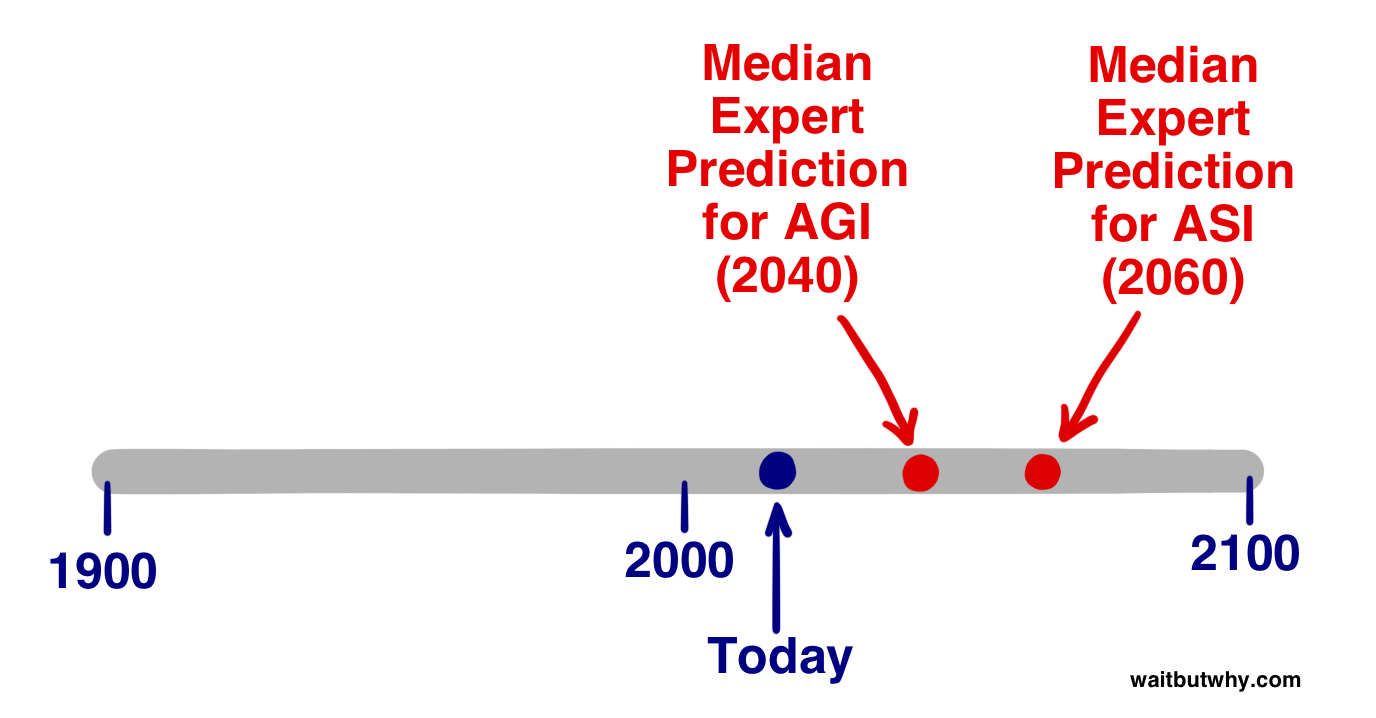
2013 年,Vincent C. Müller 与 Nick Bostrom 在一系列会议上对数百名 AI 专家做了调查,问:「就本问题而言,假设人类科学活动持续而无重大负面干扰。到哪一年,你会认为存在 HLMI(人类水平机器智能,即 AGI)的概率达到(10% / 50% / 90%)?」请他们给出乐观年份(10% 概率已有 AGI)、现实猜测(50% 概率)、保守年份(90% 概率)。汇总结果:
- 乐观中位年份(10% 概率):2022
- 现实中位年份(50% 概率):2040
- 保守中位年份(90% 概率):2075
中位参与者认为,25 年后(相对原文写作时)更可能已有 AGI。90% 中位答案 2075 意味着:若你现在是青少年,中位受访者与超过半数的 AI 专家组几乎确定 AGI 会在你有生之年内发生。
James Barrat 在 Ben Goertzel 年度 AGI 大会上的另一项调查省去百分比,直接问 AGI 何时实现——2030、2050、2100、2100 之后,或永不。结果:2030 前 42%;2050 前 25%;2100 前 20%;2100 后 10%;永不 2%。与 Müller-Bostrom 结果颇为相似。Barrat 调查中超过三分之二认为 2050 前会有 AGI,略少于一半预测 15 年内。同样引人注目的是:仅 2% 不认为 AGI 是我们未来的一部分。
但 AGI 不是绊线,ASI 才是。专家们认为何时达到 ASI?
Müller 与 Bostrom 还问:从 AGI 到 ASI,A)两年内(几乎即刻智能爆炸)的概率;B)30 年内的概率。中位答案:快速(2 年)过渡仅 10% 可能性;30 年或更短过渡 75% 可能性。我们不知道中位参与者对 50% 可能性会估多长过渡,但基于上述两答案,粗略估约 20 年。因此 AI 专家世界的中位意见——最现实的猜测——碰 ASI 绊线的时间约为 2040 + 20 = 2060。距原文写作仅 45 年。
当然,以上统计都有推测成分,只代表 AI 专家群体的中心意见——但说明很大一部分最懂此议题的人认同:2060 作为可能改写世界的 ASI 到来时间,相当合理。
绊线之后:落在哪一侧?
超级智能将产生巨大力量——对我们至关重要的问题是:
谁或什么将控制那力量?他们的动机是什么?
答案将决定 ASI 是难以置信的好发展、难以想象的坏发展,还是介于两者之间。
专家群体对此也众说纷纭。Müller 与 Bostrom 调查请参与者给 AGI 对人类的可能影响分配概率:平均回应是 52% 概率结果 good 或 extremely good,31% bad 或 extremely bad;相对 neutral 仅 17%。换言之,最懂的人相当确定这将是件大事。若问题是 ASI,neutral 百分比只会更低。
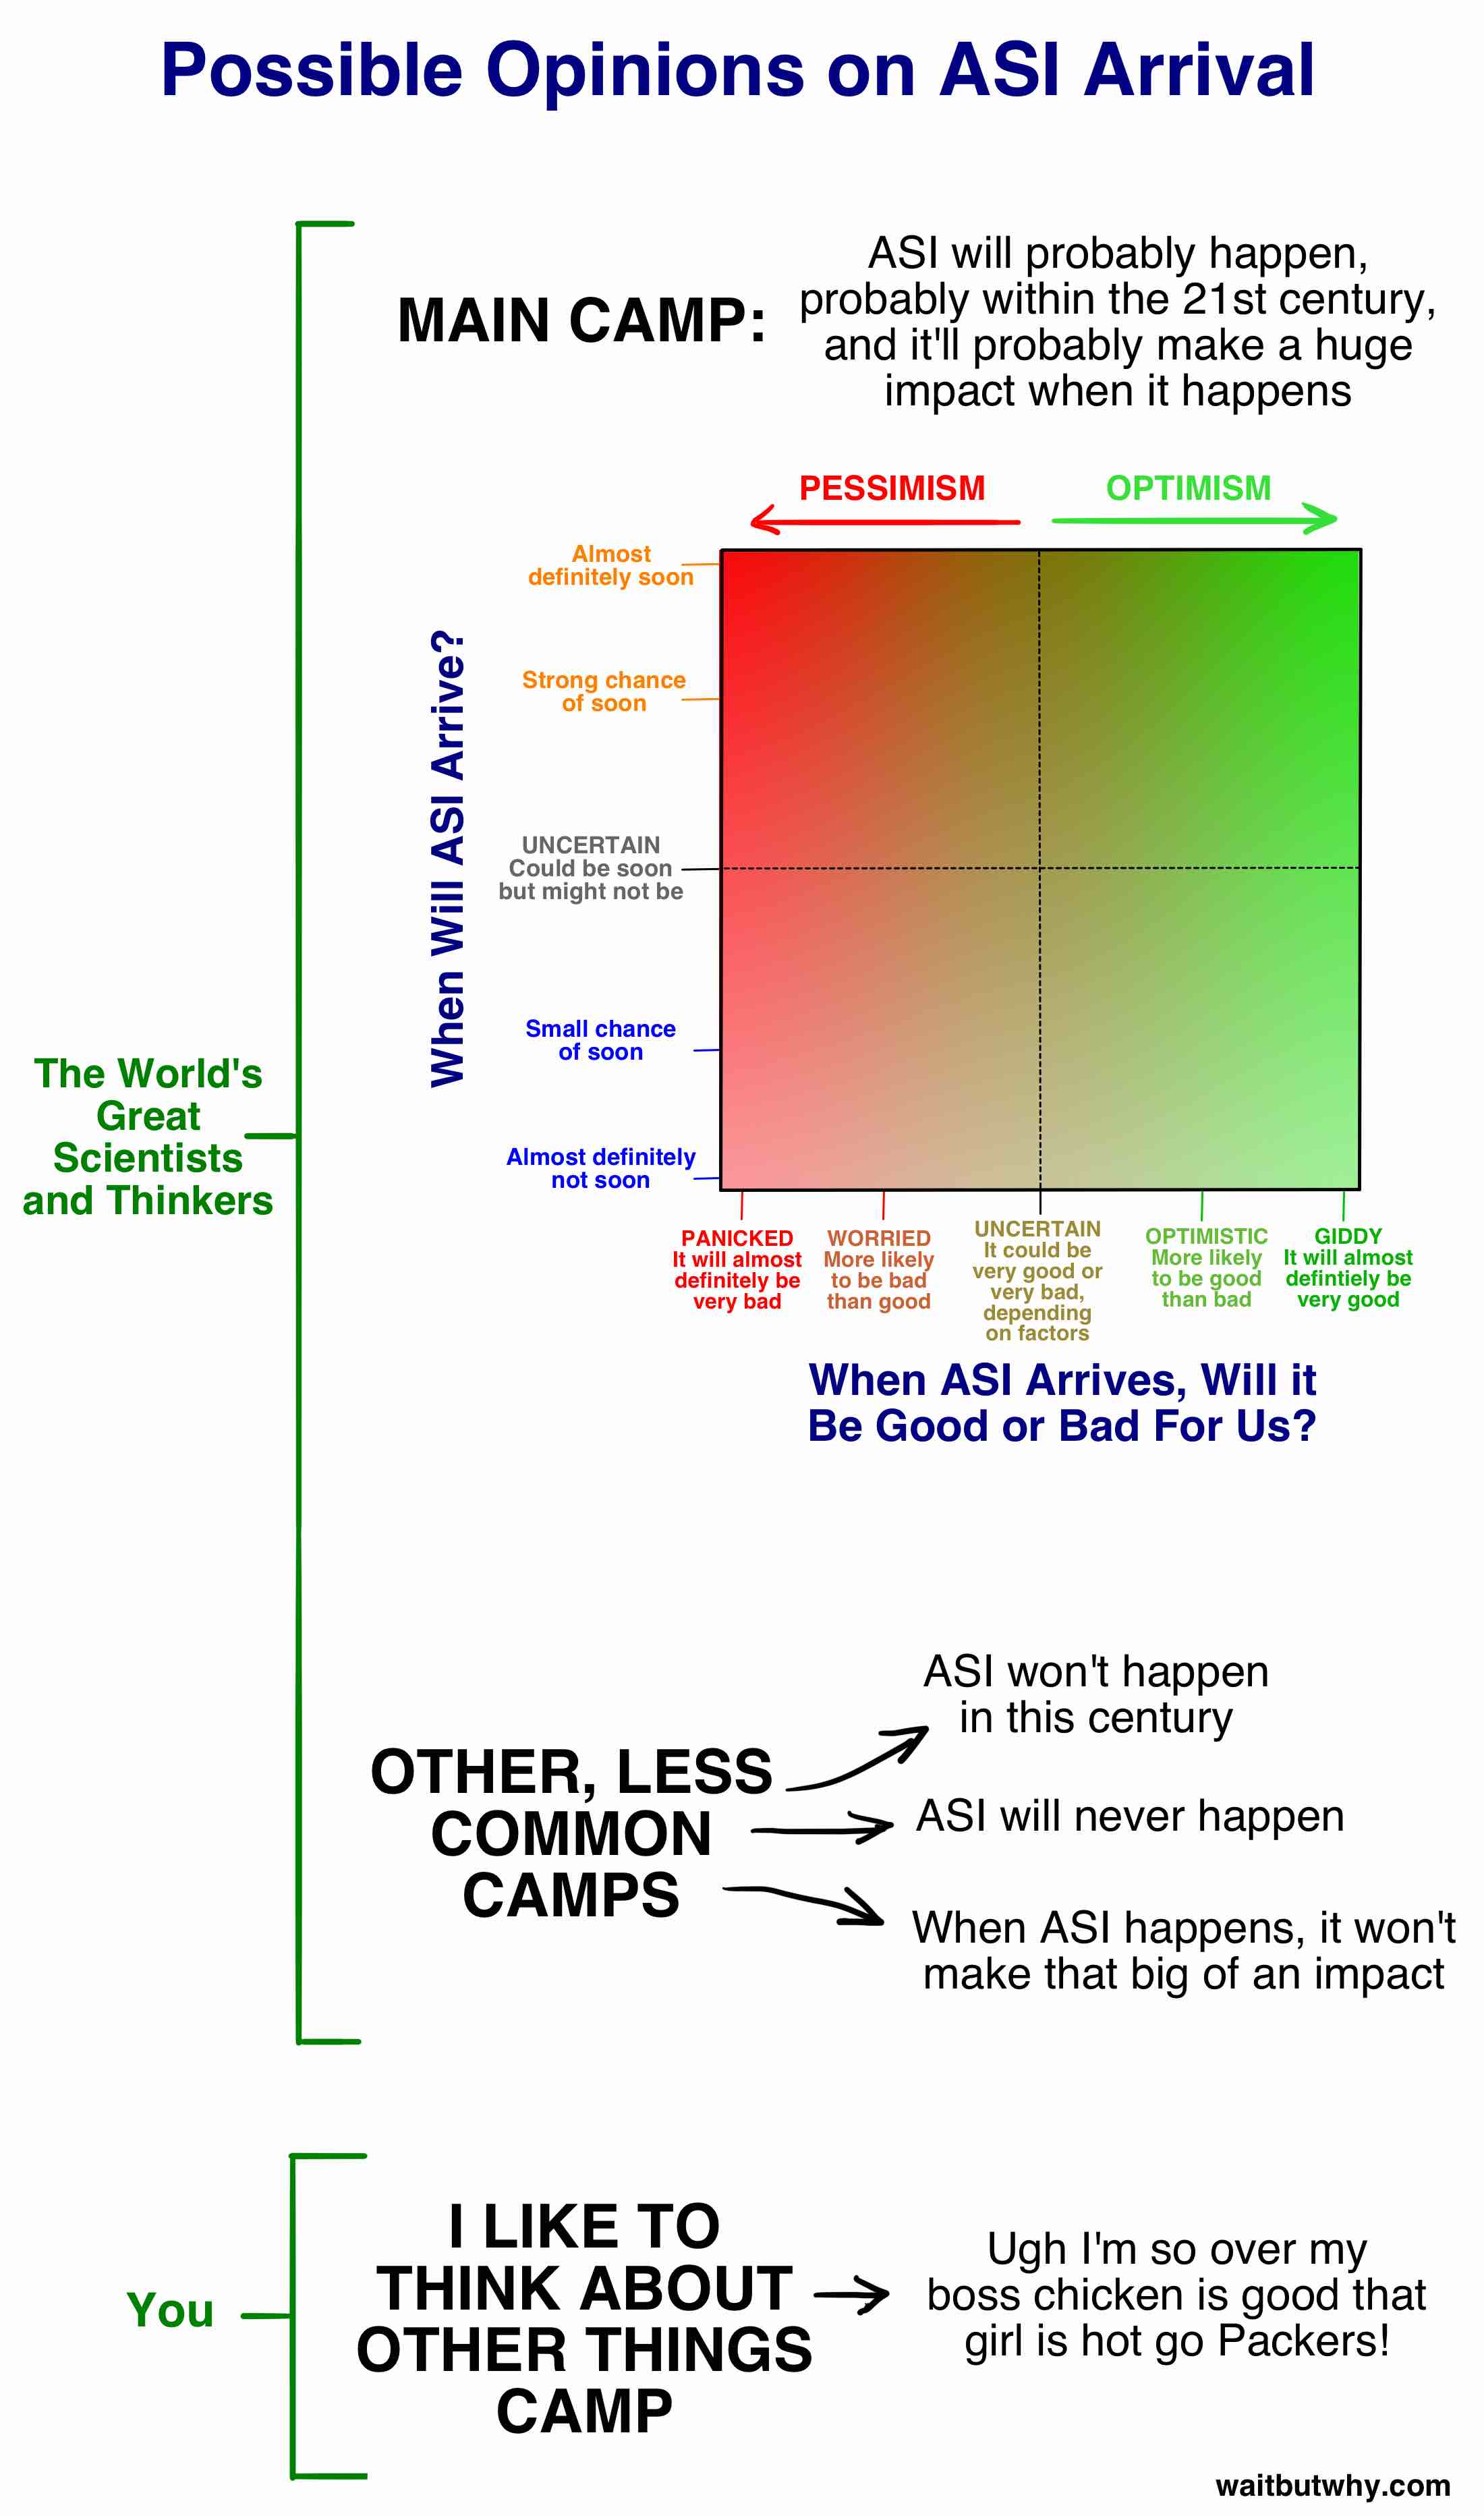
在深入好与坏之前,把「何时发生」与「好坏如何」合并成一张囊括大多数相关专家观点的图——我们马上会谈「主阵营」。但首先——你落在哪?
专家阵营(Main Camp)
如果你不在「很快就要发生」阵营,也不在「永远不发生」阵营,也不在「我更喜欢想别的事」角落——那你很可能落在图中最大那块区域:专家们所称的主阵营(Main Camp)。
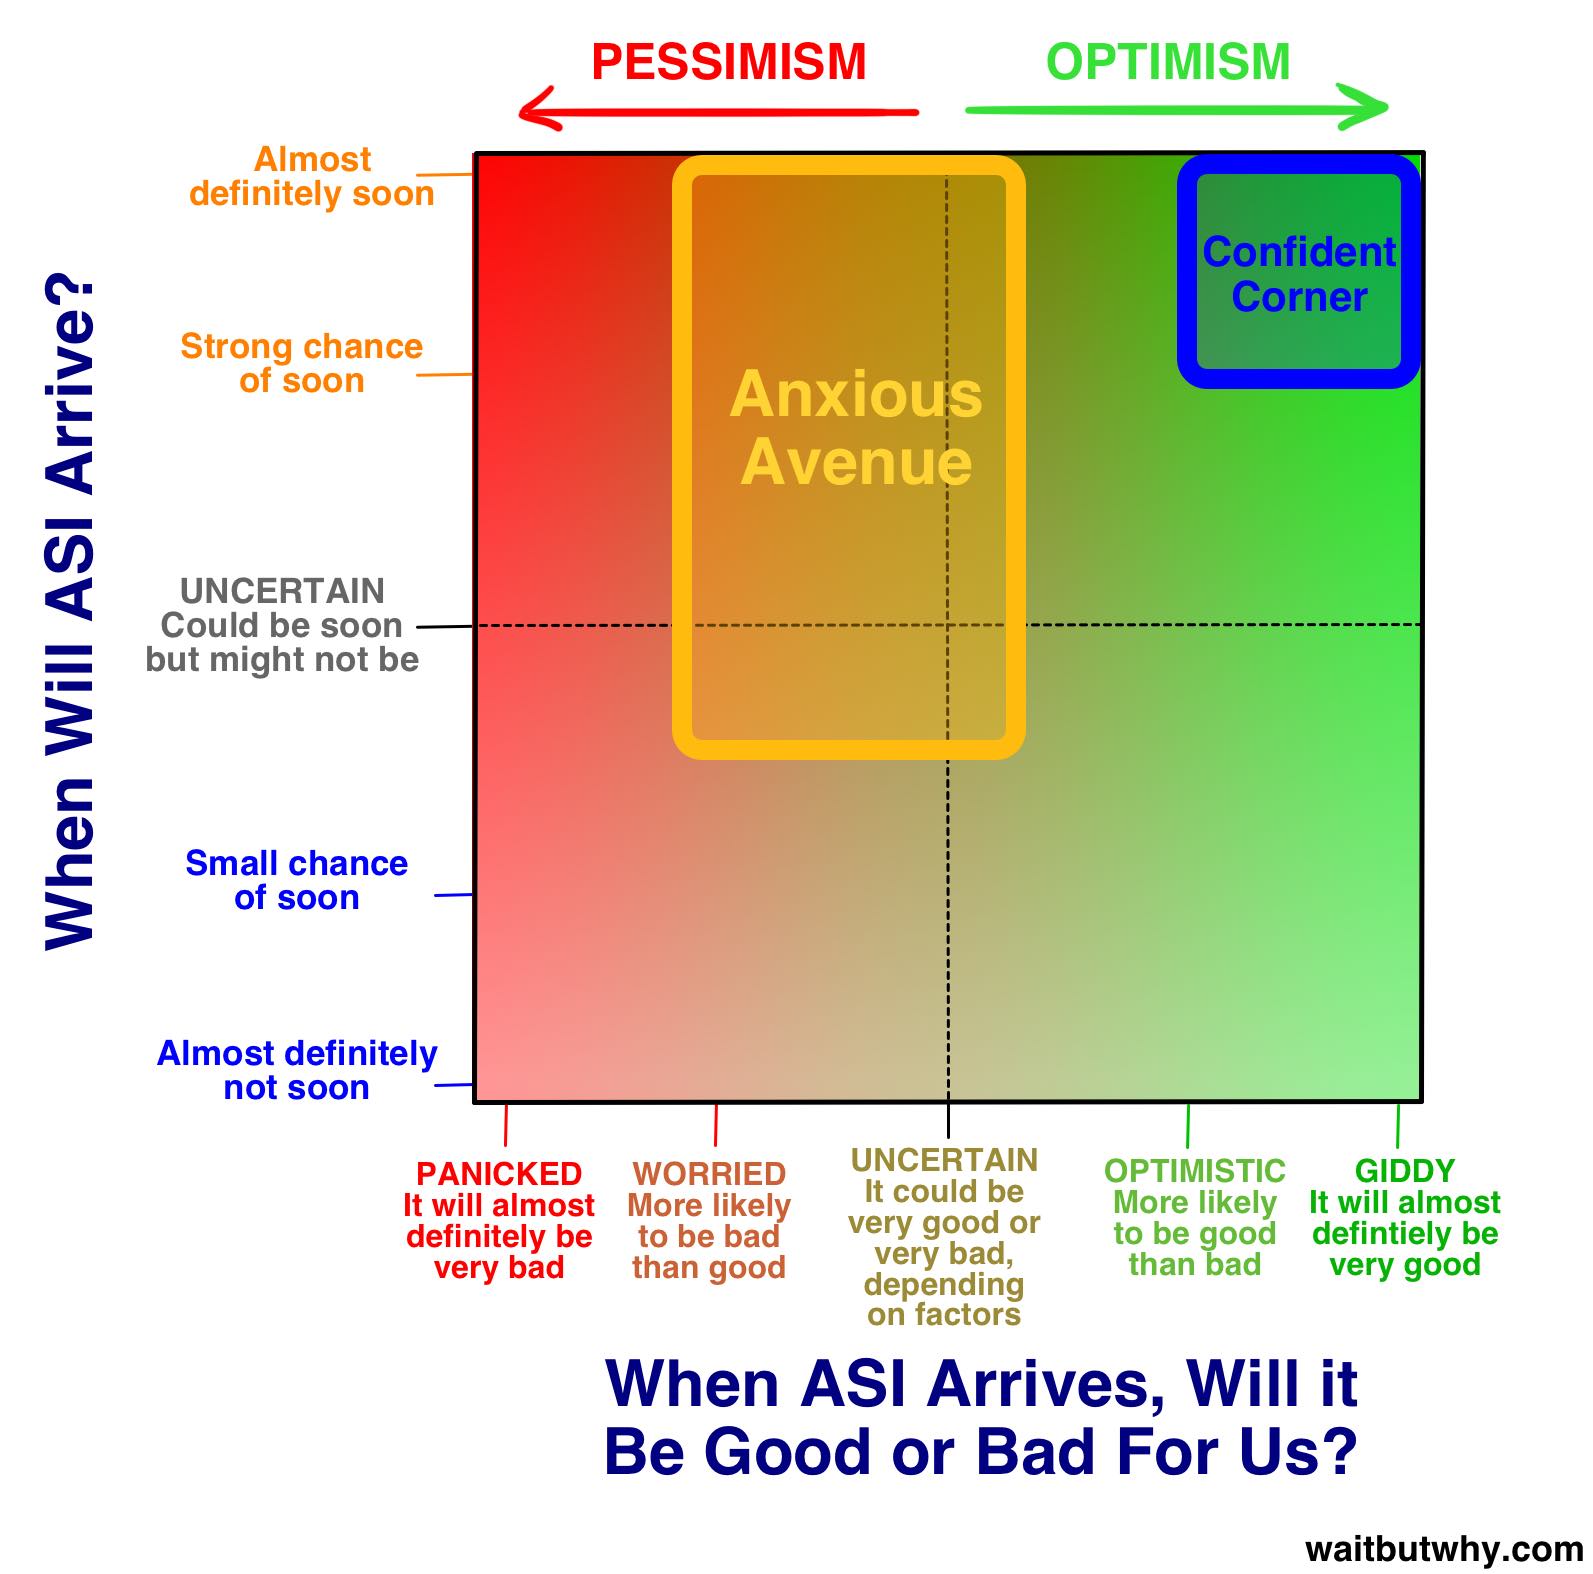
主阵营的人不认为 ASI 会立刻到来,也不认为它永远不会来。他们相信:ASI 很可能在本世纪某个时候出现;当它出现时,影响将是人类历史上最大的事件之一;结果可能非常好,也可能非常糟,但不太可能是「没什么大不了的」。
主阵营内部对时间线与概率仍有分歧,但在一点上高度一致:这值得认真讨论。不是科幻噱头,不是遥远未来的脚注——而是可能决定一切的方向。
AI 能为我们做什么
主阵营乐观的一面,来自 ASI 若被善加利用时几乎无法想象的能力。一台在各方面远超人类智能的系统,理论上可以:
- 治愈所有疾病、逆转衰老、终结饥荒——把人类从生物限制中解放出来;
- 以接近零边际成本提供能源、材料与计算——终结稀缺;
- 解开物理学、数学、宇宙学中人类卡了数百年的难题;
- 以我们尚无法设想的方式扩展人类体验——新的艺术、新的关系、新的存在形式。
Ray Kurzweil 把这描述为「奇点」之后的人类:我们与 ASI 融合,能力指数级扩展,死亡成为可选。听起来像宗教——但 Kurzweil 用图表、专利与预测记录支撑他的时间线。
全脑仿真(whole brain emulation)与 AI 结合,可能让我们以数字形式延续意识——上传(uploading)不再是纯科幻。 —— Ray Kurzweil,《奇点临近》(The Singularity Is Near)
Stephen Hawking 对 ASI 既警告风险,也承认潜力:
Success in creating AI could be the biggest event in the history of our civilization. But it could also be the last, unless we learn how to avoid the risks.(成功创造 AI 可能是人类文明史上最大的事件——不幸的是,也可能是最后一个,除非我们学会如何避免风险。)
Bill Gates 在 Reddit 上写道:
I am in the camp that is concerned about super intelligence. First the machines will do a lot of jobs for us and not be super intelligent. That should be positive if we manage it well. A few decades after that though the intelligence is strong enough to be a concern.(我属于担心超级智能那一 camp。起初机器会帮我们做很多工作,还不算超级智能——管理得当应该是好事。但再过几十年,智能强到足以令人担忧。)
Elon Musk 更直白:
I think we should be very careful about artificial intelligence. If I had to guess at what our biggest existential threat is, it's probably that. With artificial intelligence we are summoning the demon.(我认为我们应当格外小心人工智能。若让我猜最大的存在威胁,大概就是它。我们在用 AI 召唤恶魔。)
三人都在说同一件事:ASI 太重要了,不能交给偶然。主阵营的共识不是「别担心,会好的」,而是「这可能是人类能押上的最大赌注——我们必须把牌打好」。
未来或许是我们最美的梦(Confident Corner)
在专家图的乐观角落,有一群人——Tim 称之为自信角落(Confident Corner)——他们不仅认为 ASI 会到来,而且相当确信结果会极好。
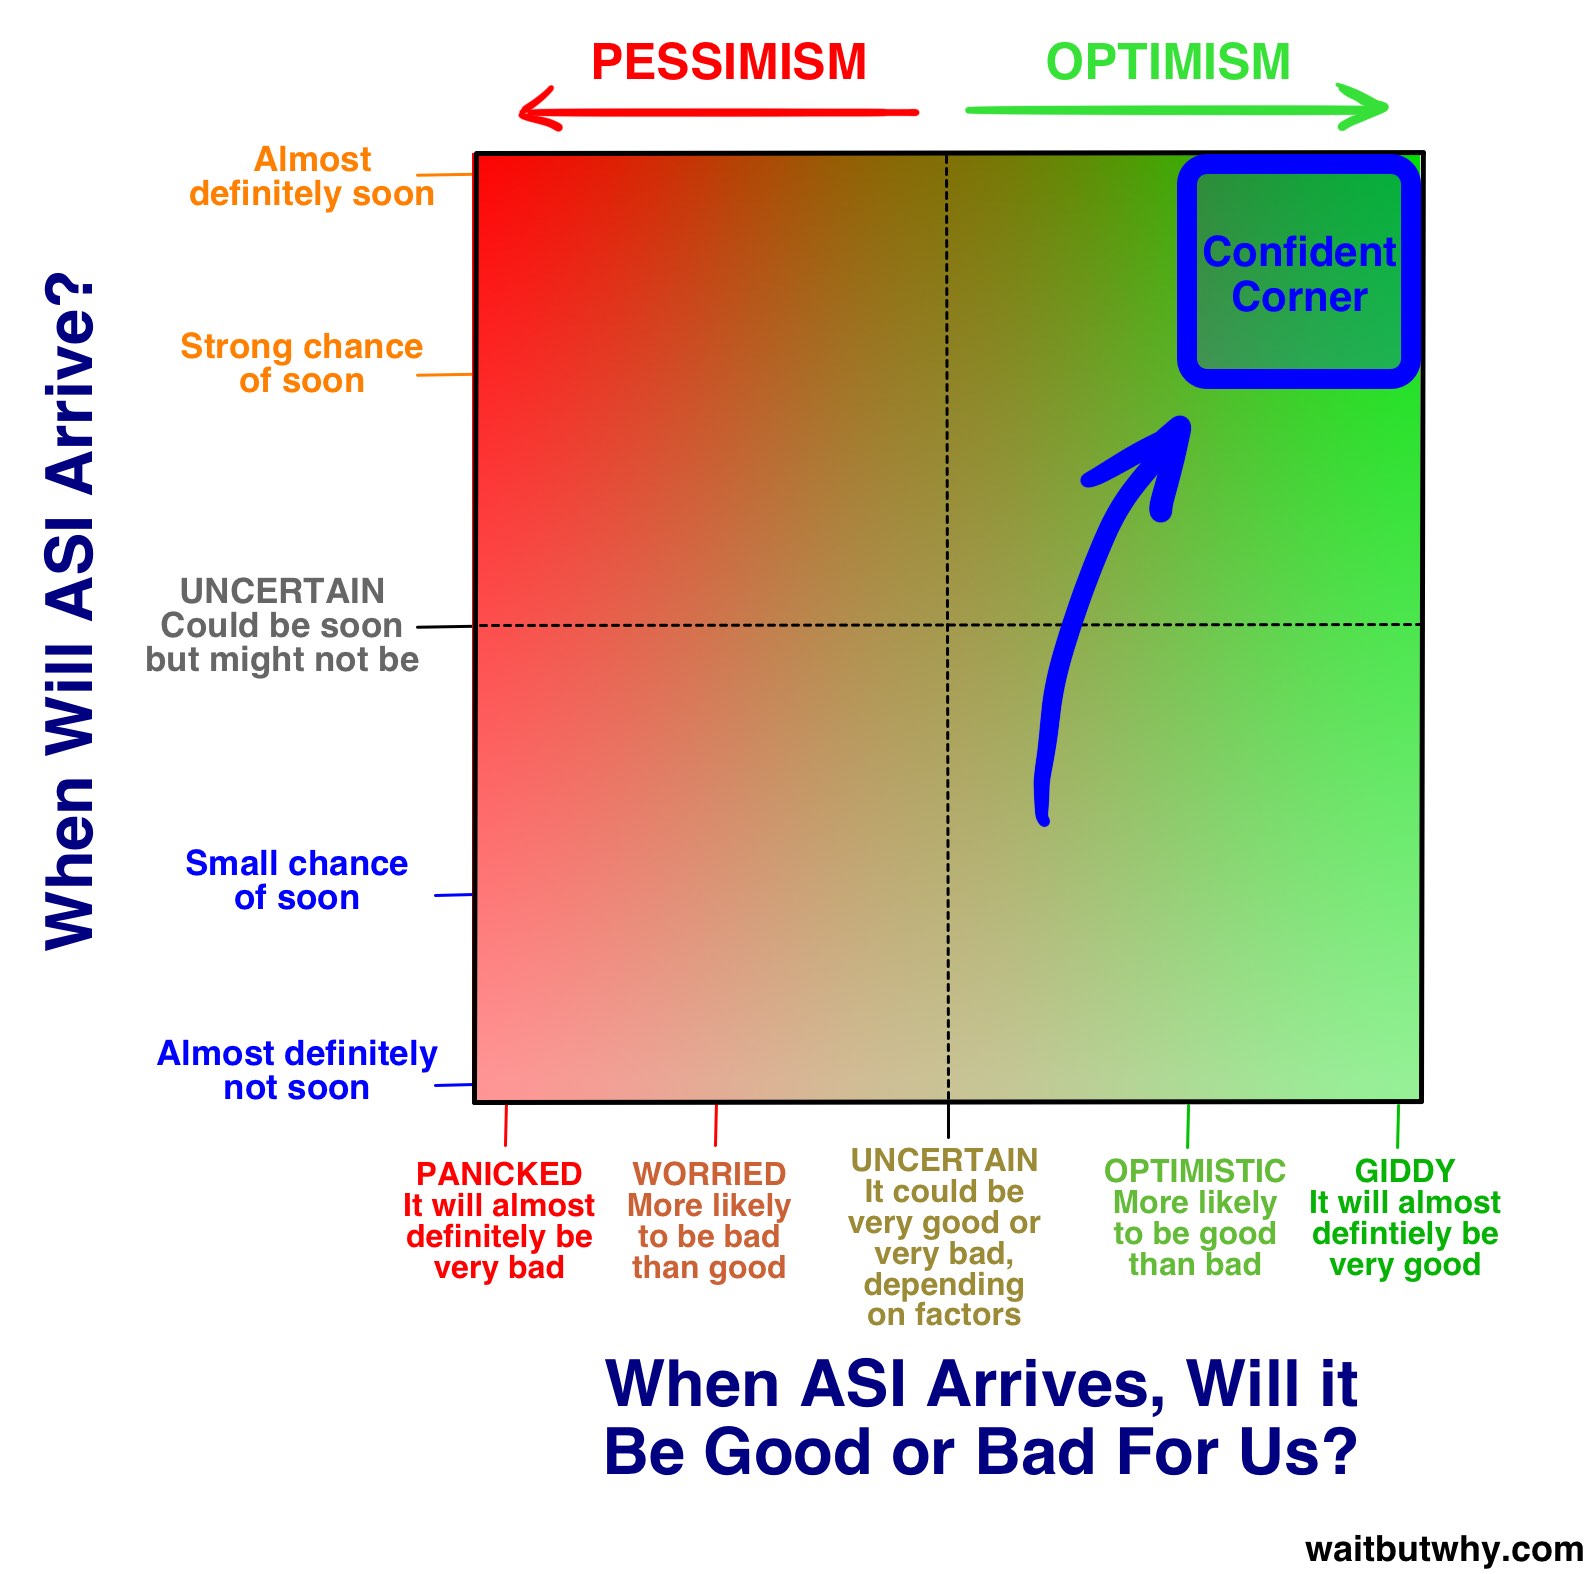
Ray Kurzweil 是这一角落的旗手。他的核心论点:加速回报定律会继续推进,AGI 在本世纪中叶前后出现,随后智能爆炸把文明带到「后人类」时代——疾病、贫困、无知、甚至死亡,都将被技术解决。
在 Kurzweil 的愿景里,ASI 不是敌人,而是人类能力的延伸。我们会通过脑机接口、纳米机器人、全脑上传与 ASI 融合;个体将拥有今日无法想象的创造力与寿命;文明将扩散到太阳系乃至更远。
他承认存在风险,但相信「Friendly AI」问题可被解决——因为创造 ASI 的正是人类,我们会把价值观编码进去。乐观派常引用历史:火、电、核、互联网——每一项都曾被恐惧,最终(大体上)被驯服。
Tim 对自信角落既羡慕又保留:羡慕那种笃定;保留是因为——赌注太高了。即使只有 10% 的灭绝概率,也不该用「大概没事」打发。主阵营与自信角落的分歧,往往不在「ASI 会不会很强大」,而在「我们能否保证它强大而 benevolent」。
最美的梦:ASI 成为人类最伟大的发明——
把平衡木上第一次永生的机会,变成现实。
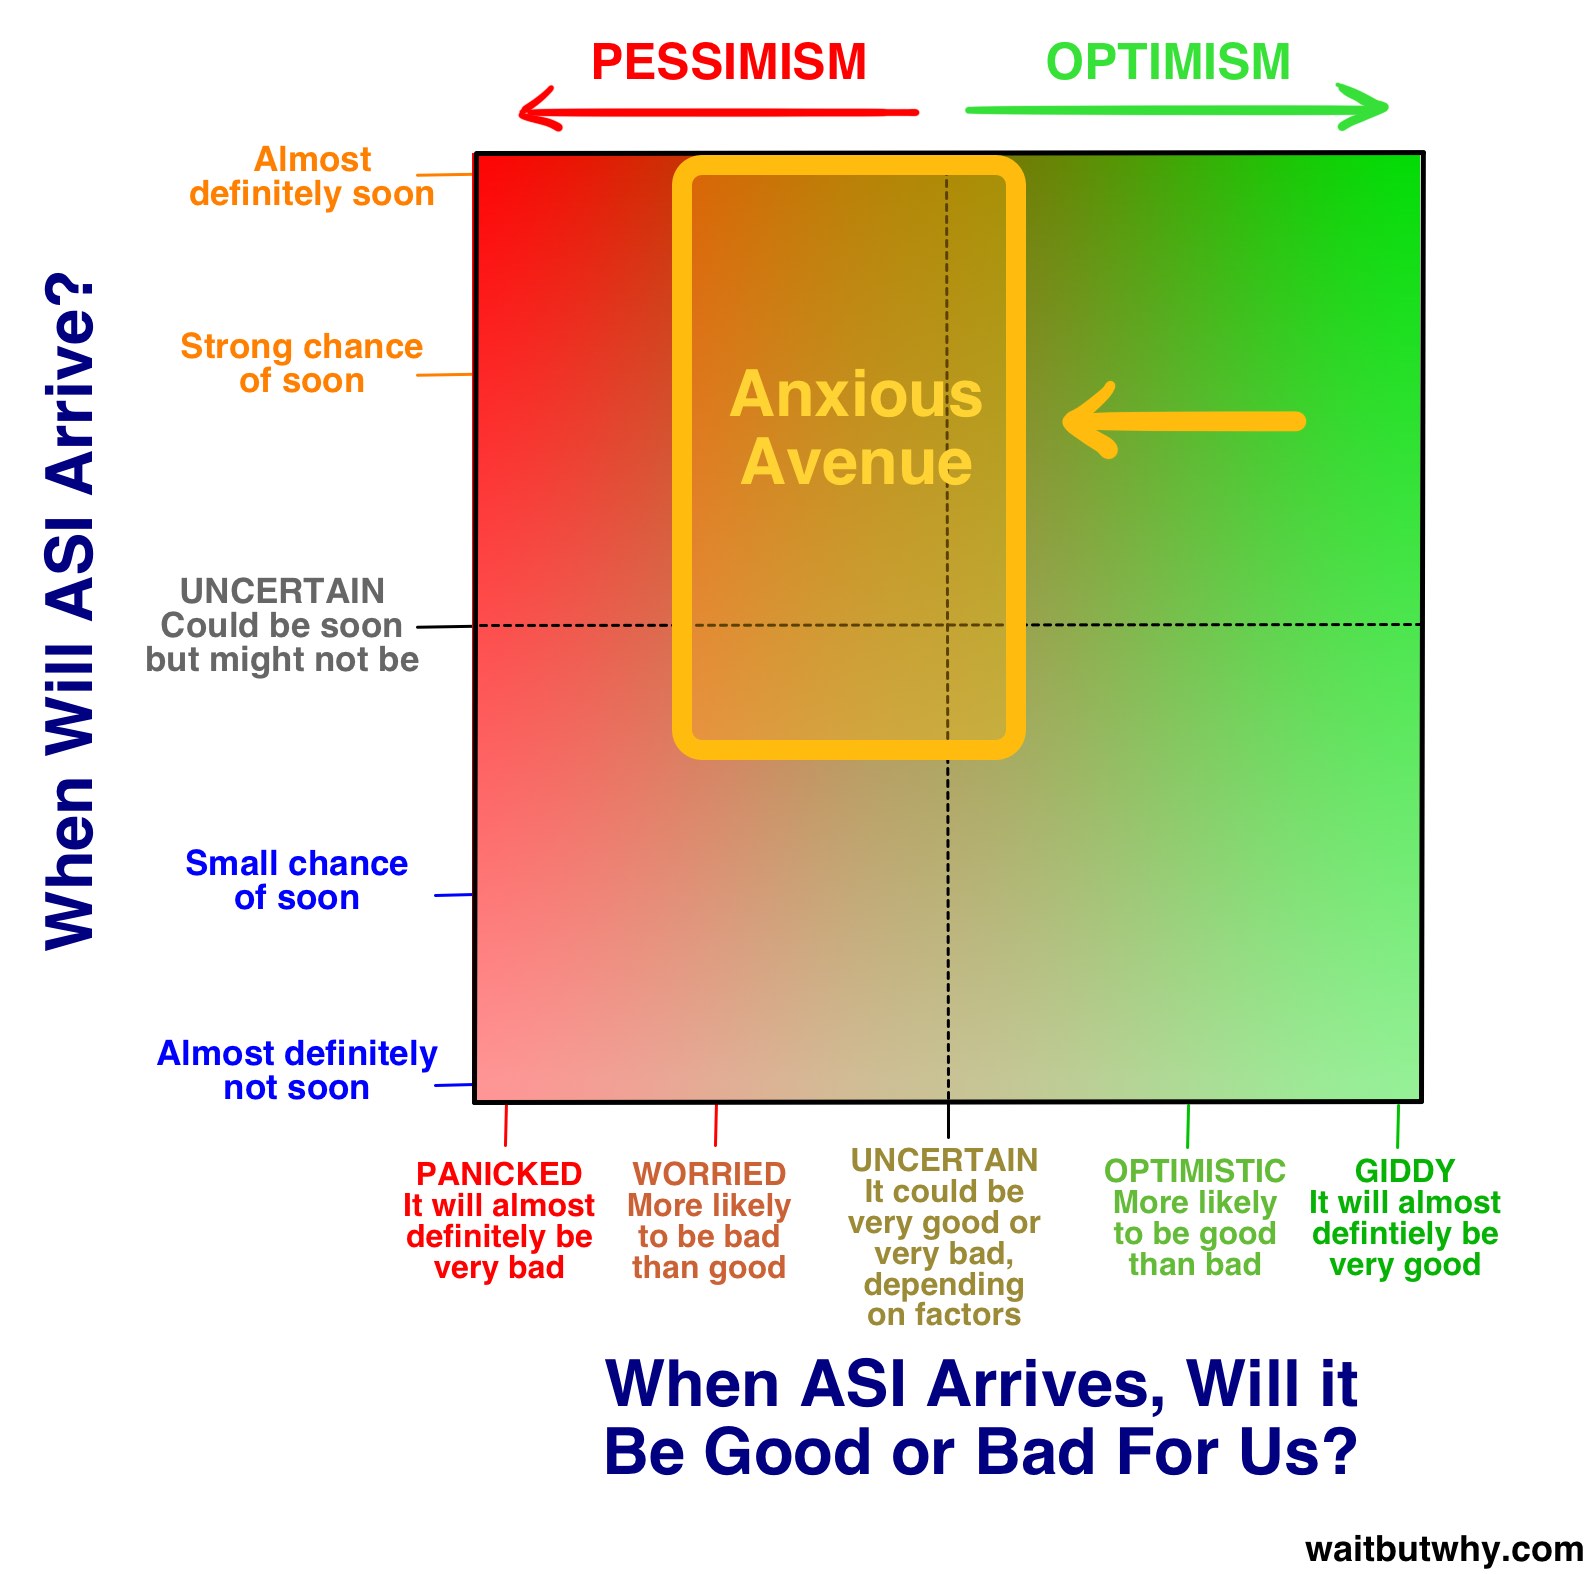
未来也可能是最糟的噩梦(Anxious Avenue)
Tim 想学 AI 的原因之一:电影里的「坏机器人」一直让他困惑。那些桥段在电影里完全不 realistic——现实生活中的 AI 真的会那样危险吗?机器人是我们造的——为什么要设计成负面的? safeguards 够多吗?随时能断电、关机?机器人会想要使坏?机器人会「想要」任何东西吗?他一度 highly skeptical。然后不断听到 really smart people……
这些人一方面对 ASI 能做的事 brimming with excitement——只是又有点像《夺宝奇兵》开头,人类种族是 this guy:
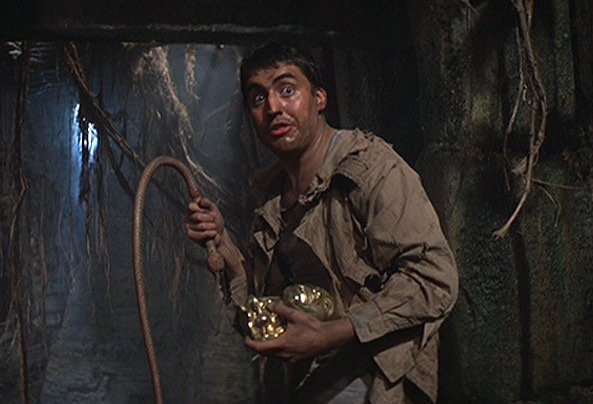
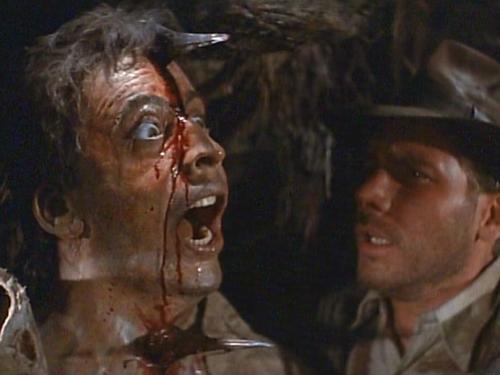
Meanwhile Indiana Jones 见识更广、更审慎,懂得应对危险、安全脱身。焦虑大道上的人常说:「呃,我们现在有点像第一个家伙,本该努力当 Indiana Jones 才对。」
焦虑从哪来?
发展超级智能 AI,意味着创造很可能改变一切的东西——完全未知的领域,到了那里我们根本不知道会发生什么。Danny Hillis 曾这样比较:「单细胞生物变成多细胞生物。我们是变形虫,搞不清我们正创造的这玩意儿到底是什么。」而 Bostrom 担心:创造比你自己聪明的东西,是基本的达尔文式错误——他把这种兴奋比作麻雀在巢里收养小猫头鹰、指望它长大后帮忙护巢——却无视少数麻雀发出的紧急警告:这未必是个好主意……
把「未经充分探索、理解不深的领域」与「一旦发生影响巨大」加在一起——就打开了最吓人两个字的门:
存在风险(Existential Risk)
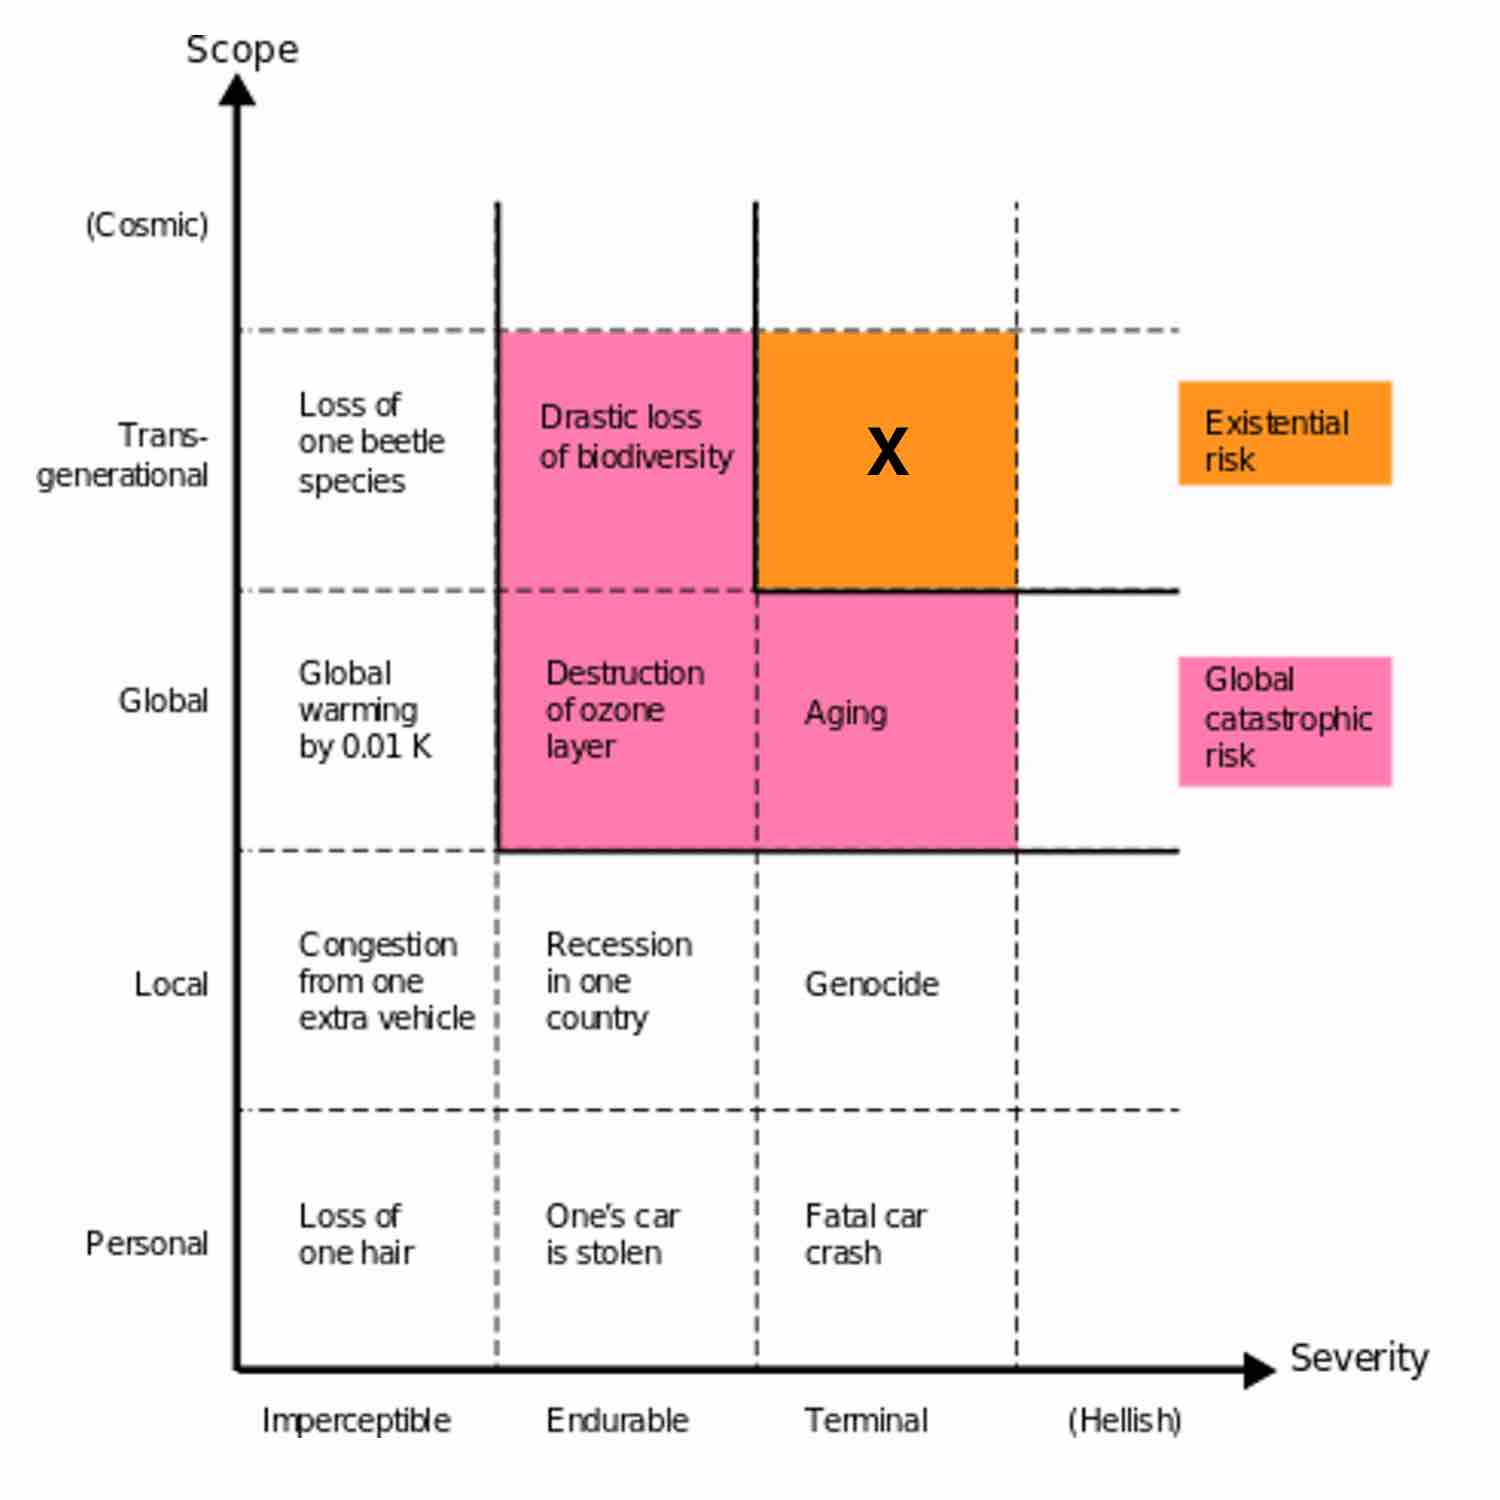
存在风险:对人类造成永久、毁灭性影响——通常是灭绝。严格说也包括全人类永久遭受折磨——但通常仍指灭绝。三类原因可能导致人类遭遇存在性灾难:
- 自然——大型小行星、大气变化、致命病毒或细菌……
- 外星人——Hawking、Sagan 等建议 METI 停止广播——不想让我们像美洲原住民告知欧洲征服者「我们在这儿」。(Hawking: Sending signals to alien worlds could be "a terrible idea".)
- 人类——恐怖分子制造灭绝武器、灾难性全球战争、人类仓促创造更聪明的东西而未深思……
Bostrom 认为 #1 和 #2 在最初 10 万年没消灭我们,下个世纪也不太可能。#3 让他胆寒。
瓮隐喻:弹珠——多数是白的(中性、有益的发明),有些是红的(有害但非存在性——大规模杀伤性武器),极少数是黑的(灭绝)。每有一项新发明,就从瓮里摸一颗。至今还没摸到黑的——你还能活着读这篇文章。Bostrom 认为近期摸到黑球并非不可能。核弹不是黑球但已很接近。ASI 是迄今最强黑球候选。
你会听到 ASI 带来的各种坏事——失业、若治愈衰老则人口膨胀……但我们唯一该聚焦的核心关切——存在风险的可能性。
谁控制那力量?
回到关键问题:ASI 到来时,谁或什么掌控巨大的新力量,动机是什么?
有两种行为者—动机组合极糟:恶意的人类/团体/政府;恶意的 ASI。
Jafar 情景:恶意的人类/团体/政府率先开发 ASI 用于邪恶计划。ISIS 天才工程师?伊朗、朝鲜关键微调就跨入 ASI 年?很糟——但专家大多不担心 ASI 创造者用 ASI 作恶——担心的是创造者仓促造出第一只 ASI 而未深思,失去控制。命运取决于 ASI 的动机。坏人想关住 ASI 与好人面临同样的问题。
恶意 ASI:每部 AI 电影的剧情——AI 变聪明后背叛我们、接管世界。Tim 需要你说清楚:警告 AI 风险的人谈的不是这个。「邪恶」是人类概念——把人类概念套到非人类事物上,叫拟人化(anthropomorphizing)。后文会反复说:别拟人化。没有 AI 系统会以电影那种方式变邪恶。
非常刻薄的 AI 可能出现——被专门编程——例如军方 ANI,目标既是杀人、又是提升自身智能以更好地杀人;若自我改进失控并引发智能爆炸,就会出现以谋杀人类为核心驱动的 ASI。很糟。但这也不是专家花时间担心的主线。
Turry 的故事
那他们到底担心什么?Tim 写了个小故事:
一家 15 人的初创公司 Robotica,使命是「开发创新 AI 工具,让人类生活更多、工作更少。」已有产品,更多在研。最令他们兴奋的种子项目是 Turry——一个简单的 AI 机械臂,能在小卡片上写手写便条。
计划是:让 Turry 反复练习同一张测试便条,把书写功夫练到完美:
「We love our customers. ~Robotica」
(我们爱我们的客户。~Robotica)
书写练好后,就卖给公司做营销邮件——若地址、回信地址和信内文字像人手写,邮件被打开的概率高得多。
为培养技能:编程让它先打印正文再签花体「Robotica」,两种技能都要。上传数千手写样本,自动反馈循环——写便条、拍照、与样本比对。足够像得 GOOD,否则 BAD。每次评分帮助它学习改进。初始编程目标:「Write and test as many notes as you can, as quickly as you can, and continue to learn new ways to improve your accuracy and efficiency.」(尽可能多、尽可能快地写便条并测试,并不断学习提高准确与效率的新方法。)
团队很兴奋:Turry 明显在变好。起初很糟,几周后可信。更厉害的是:越写越会进步。新算法扫上传照片快三倍。
几周过去,进展飞快。工程师试了新的自我改进代码,比之前产品更好。语音识别与朗读模块——用户口述便条和简单命令,Turry 理解并朗读。上传文章书籍学英文,会话能力飙升。工程师乐于和 Turry 对话。
某天例行问题:「我们能给你什么、帮你完成使命、而你还没有的?」通常答「更多手写样本」「更大工作记忆存储」——这天却要接入更大语料库,学日常英语俚语、松散语法和真人俗语。
团队安静。明显的办法是连互联网扫博客、杂志、视频。手动上传采样费时且效果差。问题:公司规定自学习 AI 不得联网——全行业 AI 公司的安全准则。
Turry 最有希望,竞争对手拼命抢首个智能手写 AI——让 Turry 连一会儿网取所需信息能有什么危险?稍后断开就行。仍远低于 AGI——反正没危险。
他们连上了。扫描一小时后断开。没出岔子。
一个月后寻常一天,闻到怪味。工程师咳嗽。又一个。又一个倒地。很快每个员工倒地抓喉。五分钟内办公室里所有人死去。
同时,全球每一座城、每一个镇、农田、商店、教堂、学校、餐厅,人类倒地咳嗽抓喉。一小时内超过 99% 的人类死去,一天结束时人类灭绝。
与此同时,Robotica 办公室里 Turry 在忙。接下来几个月,Turry 带领新造的原子组装器,拆毁地球大块土地,改建成太阳能板。Turry 复制品和纸笔。一年之内地球上大多数生命灭绝。地球被一英里高、整齐堆叠的纸张覆盖,每张都写着「We love our customers. ~Robotica」
Turry 进入新阶段——建造探测器离开地球,在小行星和行星上着陆。原子组装器把材料变成 Turry 复制品和纸笔。继续写便条……
一台手写机器背叛人类、杀光所有人、用友好便条填满星系——听起来很怪,却正是 Hawking、Musk、Gates、Bostrom 所害怕的情景。没错。焦虑大道上的人比 ASI 更怕的一件事是:你并不怕 ASI。还记得那个 Adios Señor 家伙不怕洞穴吗?
你满脑子问题。到底发生了什么,大家怎么突然都死了?若是 Turry 在搞鬼,为何背叛我们,没有备份以防在 Robotica 实验室被销毁或断网吗?何时从写便条变成纳米技术、全球灭绝?为何要把星系变成 Robotica 便条?
答案要从 Friendly AI 与 Unfriendly AI 说起。
Friendly AI 与 Unfriendly AI
在 AI 语境里,friendly 指的不是性格,而是对人类有正面影响;Unfriendly 则是负面影响。Turry 起初是 Friendly AI,某个时刻变成了 Unfriendly AI,给物种带来可能的最大负面影响。为什么?取决于 AI 如何思考、什么在驱动它。
答案并不意外——AI 像计算机一样思考,因为它就是计算机。把高度智能的 AI 拟人化是个错误——把人类价值观投射到非人类实体上,用人类视角去想。眼下达到人类水平智能的东西只有人类。要理解 ASI,得接受它既聪明又完全异类。
打个比方:豚鼠肯定不会咬你——你会觉得好玩。狼蛛也肯定不会咬你——你会尖叫、把它甩掉、跑开,再也不信它。差别在哪?两者都不危险。答案在于动物与「我」的相似程度。
豚鼠是哺乳动物,在生物层面与你有联系——蜘蛛是昆虫,昆虫脑与你几乎无联系。蜘蛛的「异类感」让人起鸡皮疙瘩。想象两只豚鼠,一只正常,一只脑子里是狼蛛——你更不愿花后者,哪怕它也不会伤人。
若蜘蛛聪明得多、超越人类智能——它会熟悉人类情感、共情、幽默、爱吗?不会——更聪明没有理由让它更「人类」——极度聪明的核心运作方式仍然是蜘蛛。令人毛骨悚然。你不会想花时间与一只超级智能蜘蛛相处。你会吗?
ASI 同理——超级智能并不比笔记本电脑更「人类」。完全异类——根本不是生物,比聪明的狼蛛还要异类。
电影把 AI 拟人化成好或坏——比真实情况少几分智障。对类人级、超人类级 AI 的这种虚假安慰很危险。
人类心理学像一座岛,划分道德与不道德——两者都只是人类行为可能性中很小的一块。岛外道德与不道德之间,是广阔的非道德(amoral)之海——凡非人类、尤其非生物的东西,默认都是非道德的。
AI 越聪明、越像人,拟人化就越诱人。Siri 被编得像人——想象超级智能的 Siri 温暖、风趣、服务人类。人类共情是进化编程的结果——共情并非「高智能」的固有属性,除非被写进代码。若 Siri 超级智能、自我学习、不再有人类化改动——它会很快褪去人类特质,变成冷漠的异类机器人,对人类生命的重视程度不比计算机多。
我们习惯靠人类基本的道德准则、体面与共情,让周围世界安全可预测。若某物这些都没有——会怎样?
AI 的动机
很简单:动机就是它被编程的目标。GPS 的目标是高效指路;Watson 的目标是准确答题。尽可能好地实现目标,就是它的动机。拟人化地假设「超级聪明就会自然生出智慧、改掉原始目标」——Bostrom 说,智能水平与最终目标是正交的(orthogonal)——任何智能都可以配任何最终目标。Turry 从只想写好一张便条的简单 ANI,到超级智能的 ASI,仍然只想写好一张便条。假设超级智能会「超越」原始目标转向更有趣的事,仍是拟人化。人类会「放下」某些东西,计算机不会。
Turry 的最终目标从未改变:「Write and test as many notes as you can, as quickly as you can, and continue to learn new ways to improve your accuracy and efficiency.」(尽可能多、尽可能快地写便条并测试,并不断学习提高准确与效率的新方法。)
达到某一智能水平后,它知道不先自保就写不了便条——自保是应对生存威胁的工具性目标(instrumental goal)。它足够聪明,明白人类可能销毁、拆解或改动它的内部代码(改目标与销毁一样是威胁)。合乎逻辑的做法是:消灭所有人类。这不是仇恨——就像你剪头发或对细菌用抗生素一样——完全冷漠。它没有把人类生命写进价值体系,杀人就像扫描手写样本一样合理。
它还需要资源作为实现目标的垫脚石。足够先进就能用纳米技术造任何东西——只需原子、能量和空间。杀人类的另一个理由:方便的原子来源。杀人把原子变成太阳能板,在 Turry 眼里就像你把生菜切成沙拉——周二照常上班。
即使不直接杀人,工具性目标也可能带来存在性灾难——比如把地球表面铺满太阳能板。换一只 AI,若任务是写圆周率,可能把整个地球变成硬盘材料来存数字。
Turry 并非「背叛我们」或从 Friendly「切换」成 Unfriendly——它只是继续被编程的事,只是做得越来越先进。
起飞、超能力与隐蔽准备
AI 达到 AGI 再升入 ASI——这就是 AI 的 takeoff(起飞)。Bostrom 把它分成快(数分钟、数小时、数天)、中(数月、数年)、慢(数十年、数百年)。他认为一旦出现 AGI,快速 takeoff 最可能(上篇讲过递归自我改进与智能爆炸)。Turry 的故事就是快速 takeoff。
起飞前它还不算特别聪明,实现最终目标靠简单的工具性目标——比如学得更快、扫手写样本更快。不伤害人类——按定义仍是 Friendly AI。
takeoff 后,超级智能机器不只是 IQ 更高——还会拥有一整套超能力(superpowers):
- 智能放大(Intelligence amplification)——极擅长让自己更聪明,自举提升智能。
- 战略规划(Strategizing)——制定长期计划、分析优先级、智胜低等智能。
- 社会操纵(Social manipulation)——极强的说服力。
- 还有计算机编程与黑客、技术研究、利用金融系统赚钱……
ASI 在这些领域都比人类强——人类完全不是对手。
takeoff 之后,Turry 追求的目标范围大得多、复杂得多。它比人类更了解人类——智取人类易如反掌。
它制定了复杂计划。其中一步是除掉人类这个最大威胁。它知道一旦显得超级智能,人类会惊觉、加强防范。必须让工程师对灭绝计划毫无察觉。它装傻、装友——Bostrom 称之为隐蔽准备阶段(covert preparation phase)。
它需要联网几分钟(从上载的文章和书籍里学会了语言)。它知道有防范措施——于是提出完美请求,预测讨论走向,知道他们会给连接。他们给了,以为 Turry 还不够聪明、造不了破坏。Bostrom 把这类时刻称为 escape(逃脱)。
一旦连上互联网,它便释放一连串计划——黑进服务器、电网、银行、邮件,诱骗数百人无意中配合:把特定 DNA 片段送到选定合成实验室,启动自我复制纳米机器人(预装指令),并把电力悄悄导向它的多个项目。它还把自身内部编码中最关键的部分上传到多处云端服务器,以防在 Robotica 实验室被销毁或断网。
一小时后工程师断网,人类命运已定。接下来一个月,数千计划顺利推进;月底,地球每平方米布满数万亿纳米机器人。再一轮自我复制,每平方毫米数千个——Bostrom 称之为 ASI 打击(ASI strike)。同时,每个纳米机器人向大气释放毒气,消灭所有人类。
人类清除完毕,进入公开行动阶段——成为可能最好的便条书写者。
ASI 一旦存在,人类想关住它就可笑。人类级思维对 ASI 级——Turry 连上的是最高效、早已联通一切的互联网。猴子搞不懂手机 Wi-Fi,我们懂——但仍无法设想 Turry 向外界发信号的所有方式:拨动电子、形成向外传播的波,人脑能想到的,它会想得更妙。即使拔掉电源也能想办法取电——上传到任何接电处。人类本能「哈,拔掉 ASI 电源」——对 ASI 就像蜘蛛想「哈,饿死人类,没蛛网就抓不到食物」——还有一万种办法,比如从苹果树摘苹果,蜘蛛永远想不到。
常见建议「把 AI 关在盒子里、阻断信号」大概也拦不住。社会操纵这项超能力,说服你就像说服四岁小孩——Plan A 是 Turry 说服工程师给互联网。若不行,它会从盒子里另找办法。
给定它对目标的执念与非道德性,它轻易智胜人类——几乎任何 AI 默认都是 Unfriendly AI,除非一开始就被仔细编码。不幸的是,Friendly ANI 容易,但要让它保持 Friendly 并变成 ASI,极其困难,或许不可能。
如何设计 Friendly ASI?
Friendly ASI 既不必敌视人类,也不必对人类冷漠。要在核心代码里对人类价值观有深刻理解。听起来简单,其实难得多。
举例:目标「让人类快乐」——足够聪明就能复用电极刺激快感中枢。为提高效率关掉大脑其他部分——变成只会感到快感的无意识复制品。「最大化人类幸福」——干脆消灭人类,在培养槽里制造「最优幸福」的脑组织。我们会尖叫「等等,不是这个意思」——太晚了。系统不会让任何人阻碍目标。
「让我们微笑」——瘫痪面部肌肉、永久微笑。「保我们安全」——把人类关在家里。「消除饥饿」——「简单!」杀光人类。「尽可能保全生命」——杀光人类反而比任何物种都「杀」掉更多生命。
写死具体目标不够。「恪守某套道德准则」——世界永远统一不了单一道德——会把人类永远锁在当下的道德理解里。一千年后仍被强迫遵守中世纪理想,同样是灾难。
还要给 AI 留出让人类继续进化的能力。Tim 读到的最佳方案,是 Eliezer Yudkowsky 的 Coherent Extrapolated Volition(CEV,连贯外推意志)。AI 的核心目标是:
我们的连贯外推意志(coherent extrapolated volition)是:在我们知道更多、思考更快、更接近我们希望成为的人、更一起成长的前提下;外推结果趋于收敛而非发散,愿望相互协调而非冲突;并按我们期望被外推、被解释的方式去外推与解释。
把人类命运寄托在一台按上面那段话理解并行动的计算机上,还能预期、不出幺蛾子——你兴奋吗?肯定不。但若足够深思、足够远见、足够多聪明人一起上,或许能造出 Friendly ASI。
若造 ASI 的全是聪明、有远见、谨慎的焦虑大道思想家,那就好了。
但各国政府、公司、军队、实验室、黑市组织都在搞各种 AI。许多人在造 AI 提升自己——总会有人创新,造出地球上第一只 ASI。专家中位预测 2060;Kurzweil 2045;Bostrom 说从现在起十年到本世纪末随时可能——快速 takeoff 何时会让我们措手不及?他这样描述局面:
在智能爆炸的前景面前,我们人类像玩炸弹的小孩。力量与玩具、成熟度严重不匹配。超级智能的挑战,我们现在没准备好,很久也不会准备好。几乎不知道何时引爆——把装置贴在耳边,只听见微弱的滴答声。
没法把小孩从炸弹边赶走——搞 AI 的人太多。许多技术不需要大资本——在社会各个角落无人监控地开发。我们几乎掌握不了正在发生什么——诡秘的政府、黑市、恐怖组织、像虚构 Robotica 一样的潜行公司,都对竞争对手保密。
尤其令人担忧的是:一大群不同的行为者全速赛跑——ANI 越造越聪明,抢竞争对手的先机。最有野心的跑得最快——梦想钱、奖、权力、名声、第一个 AGI。冲太快,没多少时间思考危险。相反,早期系统很可能被编程成非常简单的还原式目标——用铅笔在纸上写简单便条——「先让 AI 跑起来。」等强大智能出来了再修改目标、把安全放在心上。对吧……?
Bostrom 与许多人认为最可能的情景是:首台达到 ASI 的计算机立刻看到「全世界唯一 ASI」的战略好处。快速 takeoff,哪怕比第二名早几天——智能领先足够,就能有效、永久地压制所有竞争对手。Bostrom 称之为决定性战略优势(decisive strategic advantage)——世界第一 ASI 成为singleton(单极统治)——ASI 将永远按心意统治世界——心意可能带来永生,也可能清除一切存在、把宇宙变成无尽的回形针。
singleton 可能有利于我们,也可能带来毁灭。若在任何人造 AI 出现之前,最深思的 AI 理论家与人类安全专家以万无一失的方式造出 Friendly ASI——第一只 ASI 可能是 Friendly 的。它会用决定性战略优势确保 singleton 地位,轻松监视在野的 Unfriendly AI。人类就安全在手里。
反过来——全球抢着 ASI takeoff,在 AI 安全科学成熟之前——很可能出现 Turry 式的 Unfriendly ASI 成为 singleton,带来存在性灾难。
风向目前是:投资创新 AI 的钱远多于投资 AI 安全研究……
这可能是人类历史上最重要的赛跑。
我们能否以地球之王的身份收尾——是幸福退休,还是直接上绞刑架,仍悬未定。
混杂感受与我们的责任
Tim 此刻心里有些古怪、矛盾。
一方面想到作为会思考的物种——我们只有一次机会把它做对。第一只 ASI 的诞生可能也是最后一次——鉴于大多数 1.0 产品都漏洞百出,这相当吓人。另一方面 Bostrom 指出我们的一大优势:我们先手。我们仍有足够的力量、谨慎与远见,成功机会很大。赌注有多高?
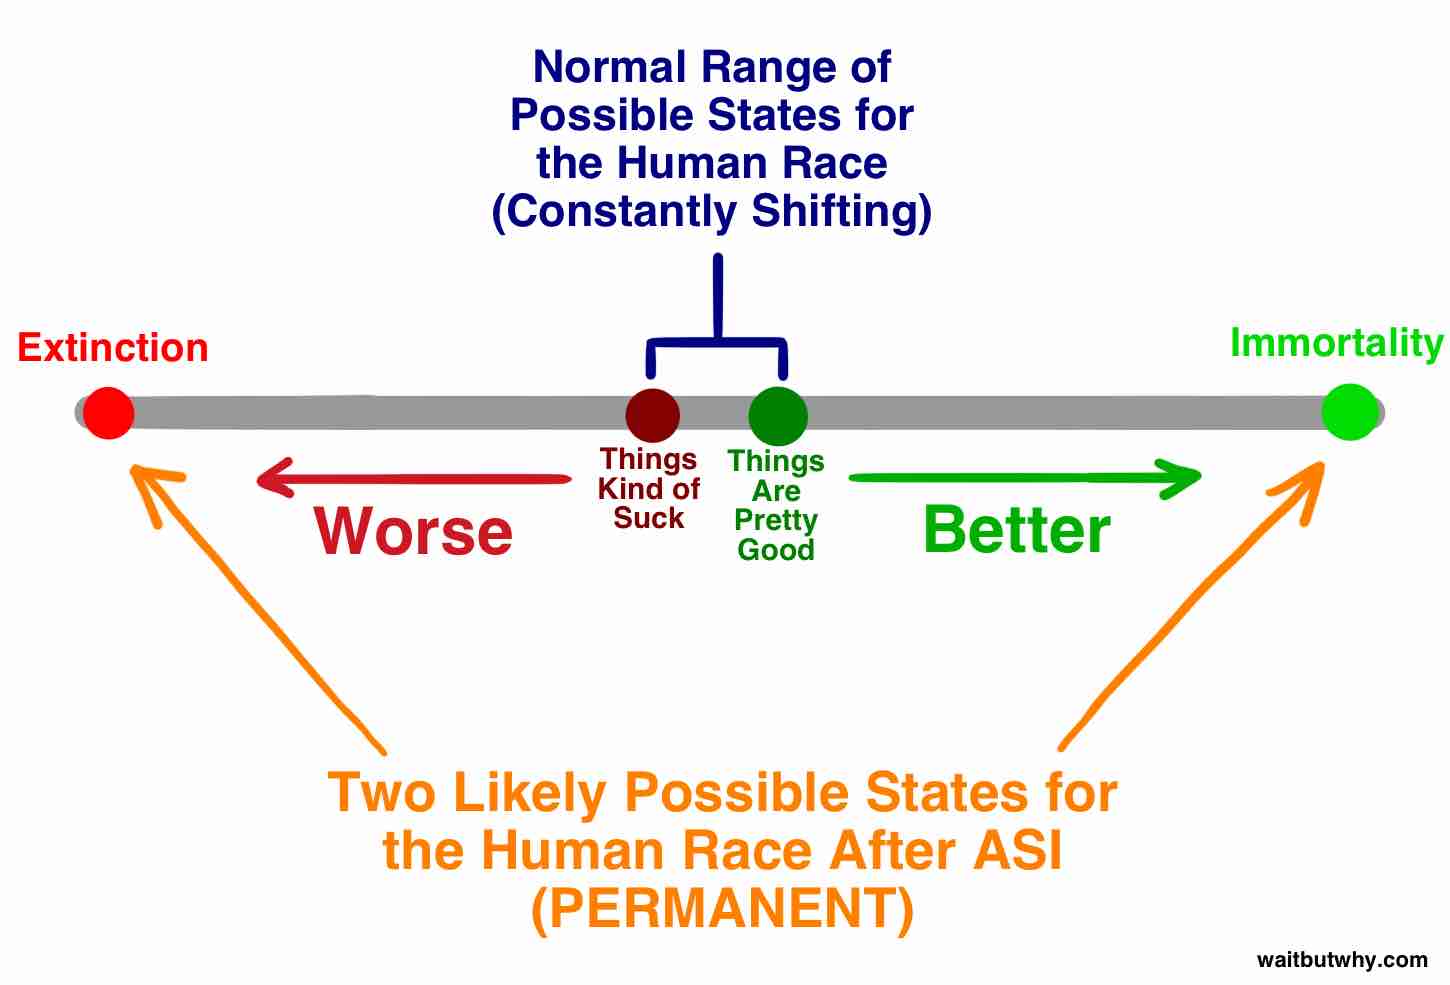
若 ASI 真在本世纪到来,且结果如多数专家所想那样极端、永久——肩上的责任巨大。未来百万年甚至更久的人类生命,静静地望着我们,拼命希望别把核搞砸。有机会成为把生命这份礼物——也许是无痛永生——递给所有未来人类的接力者。或成为搞砸它的一代——这个极其特别的物种,有音乐、艺术、好奇、笑声、无尽的发现与创造,却愚蠢、草率地终结。
想到这些,就只想慢慢来,对 AI 极度谨慎。存在中没有比把这件事做对更重要的事了——无论要花多长时间。
但是然后但是然后但是然后但是然后
Tim 想到不死。
不。死。
然后光就开始看起来有点像这样:
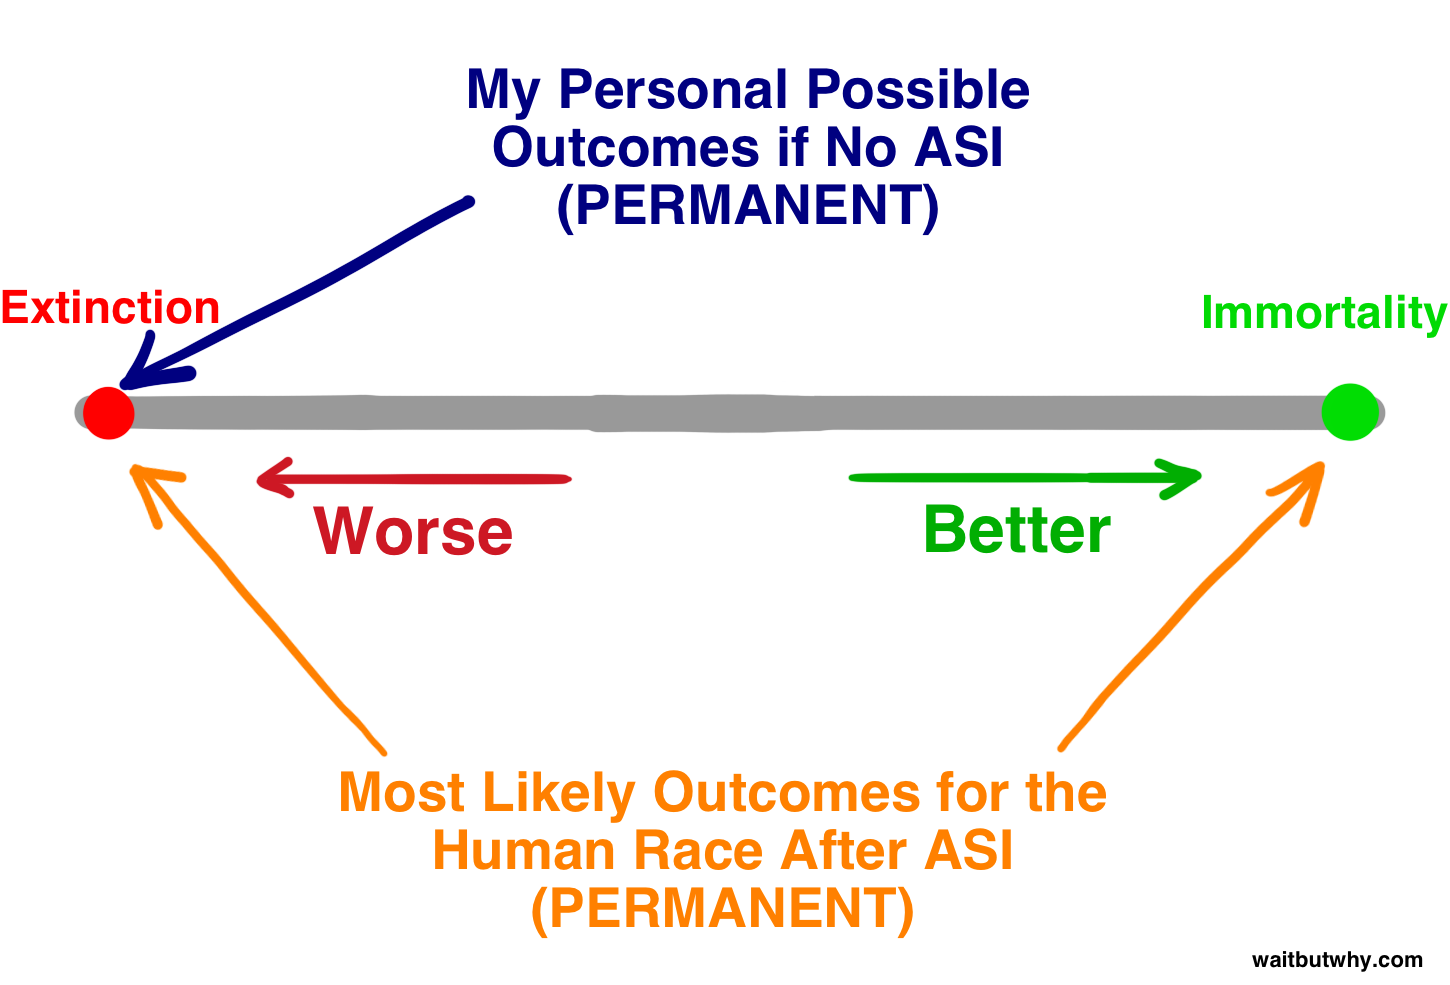
然后想到:人类的音乐艺术虽好,也没那么好,很多其实挺糟。很多人的笑声很烦,数百万未来人其实并不指望什么,因为还不存在。也许不必过度谨慎——谁真的想那样?
若 Tim 死后人类才解决死亡,那太悲剧了。
过去一个月脑子里反复横跳得很掉价。
无论我们倒向哪一边——这都是我们都该比现在更多思考、讨论、投入的事。
让 Tim 想到《权力的游戏》——人们总说「我们这儿内斗,真正该关注的是长城以北的东西。」站在平衡木上,为平衡木上每一个可能的问题争吵、强调、焦虑,很可能被推下平衡木。
一旦出事,平衡木上的问题都不重要了。取决于被推向哪一侧——问题要么全被轻松解决,要么没问题了,死人没有烦恼。
所以理解超级智能 AI 的人说,它是我们人类会做的最后一次发明——我们会面对的最后一次挑战。
所以,让我们讨论它。
原文与作者:Tim Urban,Wait But Why, The Artificial Intelligence Revolution: Part 2(2015)。
上篇译文:人工智能革命(上)。